
2026年6月9日,人工智能公司 Anthropic 正式發布Claude 5 Fable,呢個係其 Mythos 級模型首次向公眾開放嘅版本。Claude 5 Fable 被 Anthropic 定位為“為最雄心勃勃嘅工作而生”嘅模型,專注於長時程推理、自主編碼同複雜知識工作,喺軟件工程、科學研究、視覺理解同多日期 Agent 任務表現出領先能力。呢個模型嘅發布標誌住 Anthropic 由“安全受限”向“可控普惠”轉型嘅重要一步,亦為 AI Agent 喺實際生產環境中嘅大規模應用提供咗新基石。
Claude 5 Fable 係 Anthropic Mythos 系列嘅“安全版”,此前 Mythos Preview 因為網絡安全能力過於強大而只限 Glasswing 項目合作夥伴使用。Fable 5 喺保留核心能力嘅同時,加咗更嚴格嘅安全防護,令佢可以面向廣大用戶開放。
核心技術特點
1. Mythos 級長時程推理能力 Claude 5 Fable 最大嘅亮點係佢對長時程、多步 Agent 任務嘅出色處理能力。模型支援1M token超長上下文窗口,輸出上限達128K token,能夠喺數天甚至數週嘅複雜任務中保持高度一致性同規劃性。Anthropic 表示,喺長週期任務中,Fable 5 嘅優勢會隨住任務複雜度增加而進一步擴大。
2. 自主編碼與知識工作優化 Fable 5 喺軟件工程同知識工作領域嘅表現尤為突出。佢能處理大規模代碼庫遷移、複雜系統重構同多文件協同開發等真實工程任務。喺 Stripe 一個5000萬行 Ruby 代碼庫遷移項目中,Fable 5 只用咗一日時間就完成咗團隊預計需要兩個月嘅工作,展示出強大嘅實際工程能力。
3. 多模態與視覺能力增強 模型喺視覺理解同多模態任務上都有顯著提升,支援圖像、文件同屏幕截圖輸入,喺 OfficeQA Pro、Spatial Reasoning 等基準上取得領先成績。
4. 安全與可控性設計 Fable 5 內置咗更強嘅安全分類器,喺網絡安全、生物同化學等高風險領域設置咗嚴格防護。當檢測到潛在風險時,模型會自動回退到較安全嘅 Opus 4.8 行為模式,確保大規模部署嘅安全性。
性能指標與基準表現
根據 Anthropic 官方系統卡同第三方評測,Claude 5 Fable 喺多個關鍵基準上取得領先:
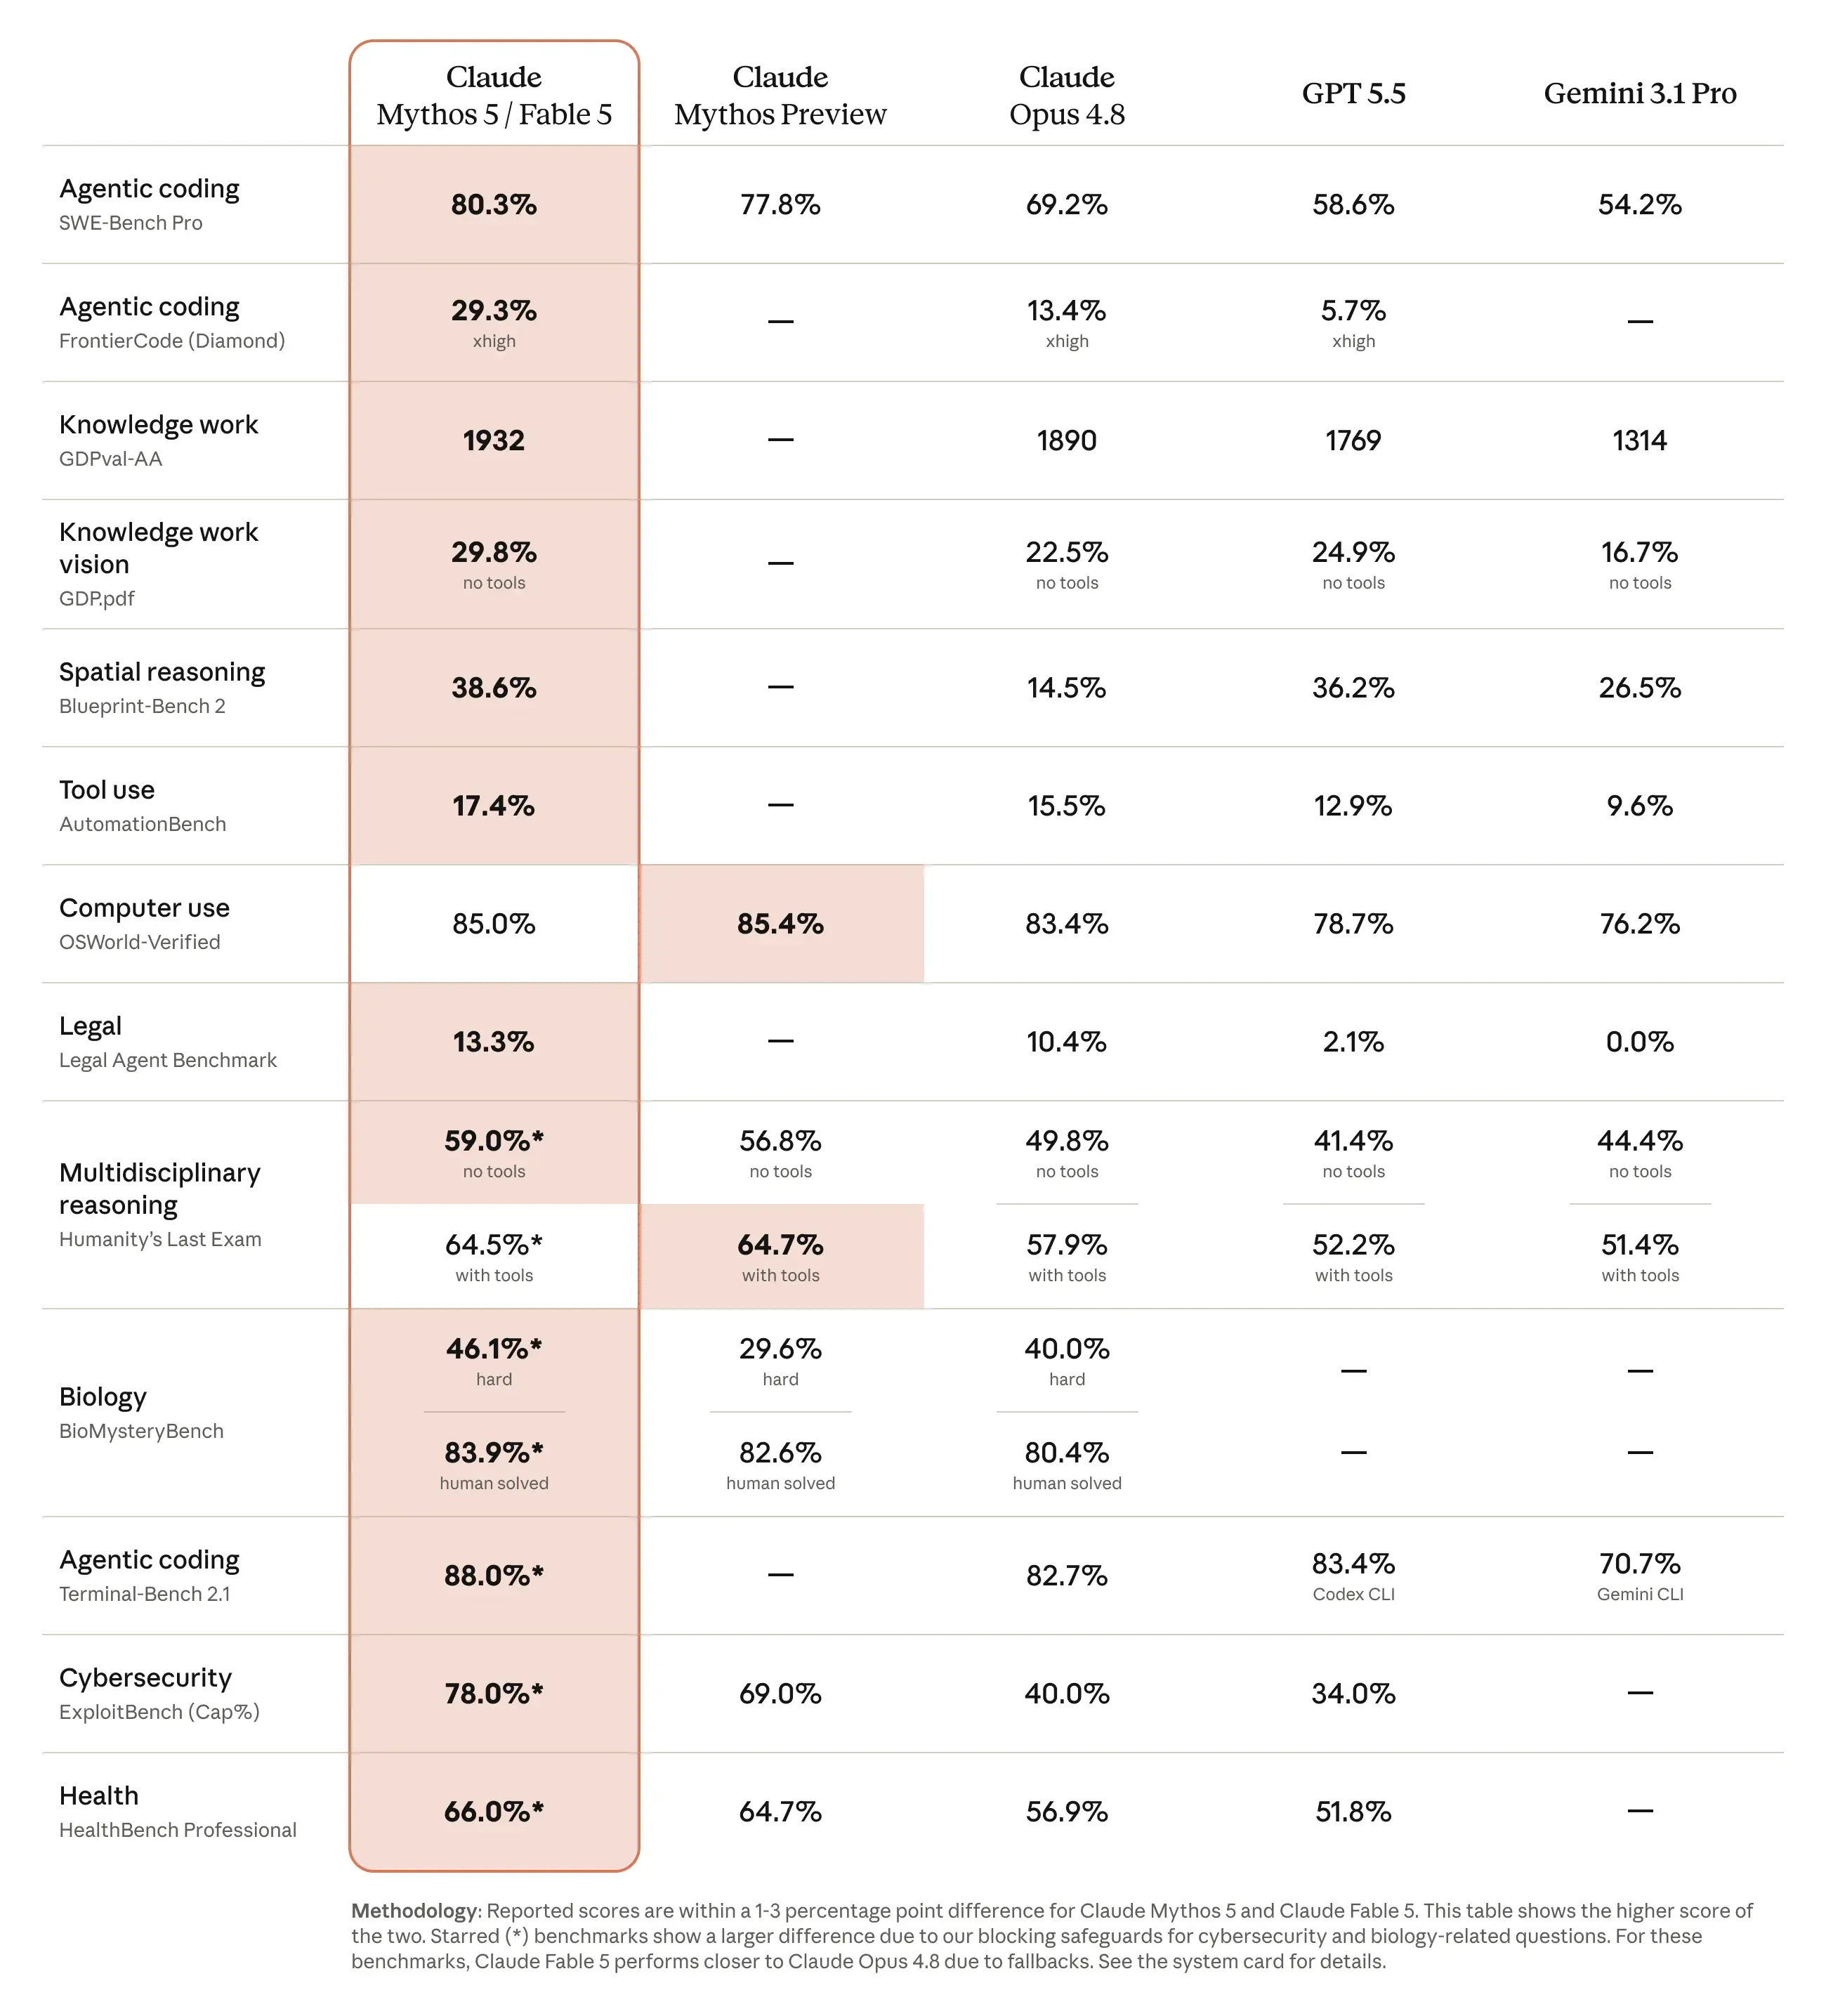
- Agentic Coding(SWE‑Bench Pro 軟件工程基準):80.3%,領先第二名11個百分點。
- Agentic Coding (FrontierCode Diamond):喺高難度生產級代碼庫任務中表現突出,即使喺中努力模式下亦領先。
- Spatial Reasoning:38.6%,較 Opus 4.8 提升近3倍。
- Legal Reasoning:13.3%,遠超 GPT‑5.5(2.1%)同 Gemini(0%)。
與前代 Opus 4.8 相比,Fable 5 喺準確率上提升約20%,工具調用次數減少12%,但生成速度略慢(約慢30%),且輸出 token 數量增加2.5倍,體現出“質量優先”嘅設計理念。
定價與可用性
- API 定價:輸入 $10 / 百萬 token,輸出 $50 / 百萬 token。
- Claude.ai 訂閱:Pro、Max、Team 同企業用戶喺6月9‑22日期間免費使用,之後按信用額度計費。
- 可用性:已全面上線 Claude API、AWS Bedrock、Google Vertex AI、Microsoft Foundry 等平台。
行業意義與影響
Claude 5 Fable 嘅發布,係 Anthropic 喺2026年最重要嘅產品動作之一。佢唔單止將此前高度受限嘅 Mythos 級能力帶畀普通用戶,亦為 AI 喺軟件開發、科學研究同知識工作領域嘅落地提供咗強大嘅工具。
呢次發布進一步加劇咗 AI 前沿模型嘅競爭。OpenAI 嘅 GPT‑5.5、谷歌嘅 Gemini 系列同 Anthropic 嘅 Claude 系列喺長時程 Agent 能力上嘅比拼正進入白熱化階段。Fable 5 嘅出現,亦促使行業更加重視喺安全可控前提下嘅能力開放,為負責任 AI 發展提供咗新範例。
對開發者嚟講,Fable 5 強大嘅編碼同多步推理能力,會顯著提升生產力;對企業用戶嚟講,佢提供咗更可靠嘅 Agent 解決方案;對整個行業嚟講,呢次發布再次證明:長時程規劃同自主執行能力已經成為下一代 AI 競爭嘅核心戰場。
▶️ 鍾意呢篇內容?創作真係好辛苦!
歡迎關注我哋嘅 YouTube 頻道:
AI Rosetta
你嘅讚好、訂閱同分享,係對我哋最大嘅支持!🙏
更多 AI 新聞請瀏覽:https://www.airosetta.com