
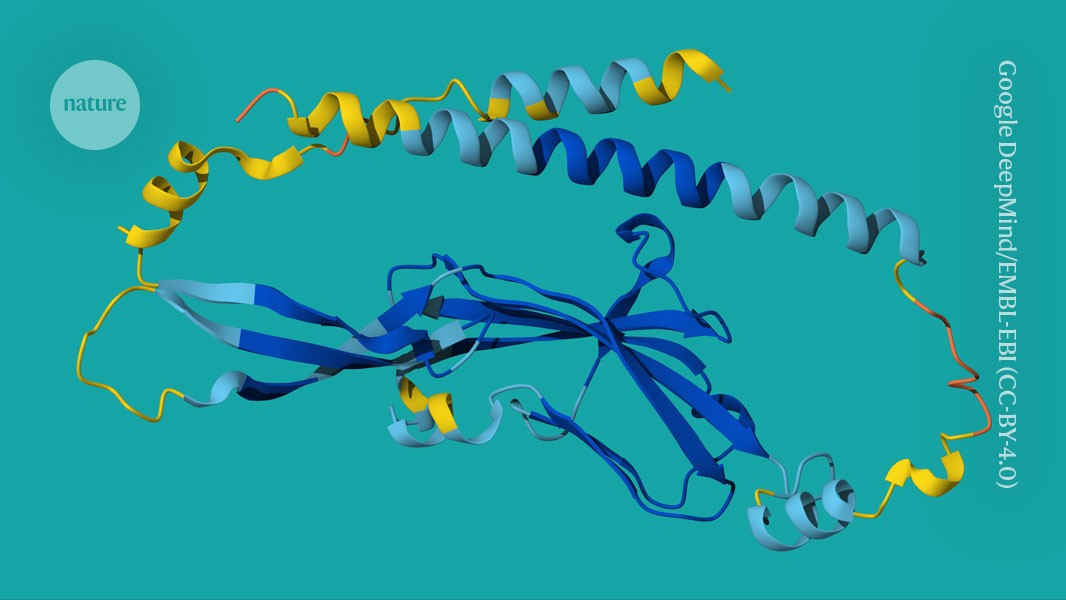
2025年11月26日,Nature發表嘅一組圖表集中睇一個已經改變科研工作方法嘅工具:AlphaFold。文章用時間序列同領域分佈圖,展示AlphaFold自2020年問世後點將「未知三維結構」逐步變成「可獲得嘅模型」。
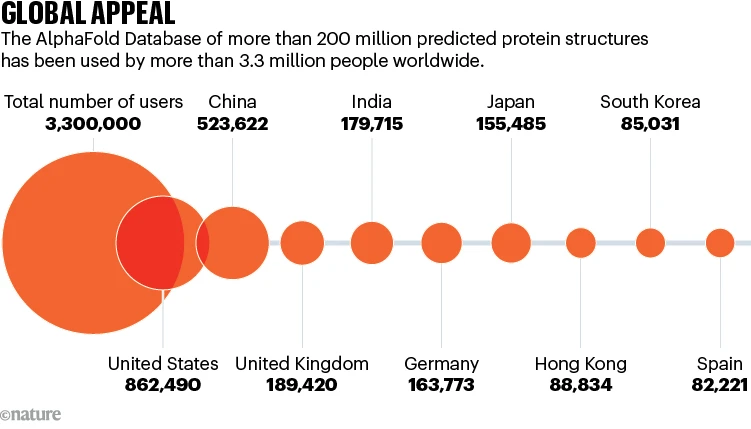
圖表一顯示數據庫規模嘅爆炸式增長:由早期幾萬條預測快速擴展到覆蓋數以億計嘅蛋白序列,當中唔單止有模式生物嘅蛋白,仲包括大量未培養微生物同環境樣本嘅序列預測。呢種規模帶嚟嘅直接效果係喺好多研究入面,實驗團隊唔再由零開始估計折疊拓撲,而係以AlphaFold模型做起點,慳返數月到數年嘅結構驗證時間。
另一組圖利用引用量同領域滲透率顯示採用速度:喺結構生物學嘅論文入面引用AlphaFold嘅比例喺短短幾年內急增,藥物研發、酶工程、植物科學同微生物生態學等領域嘅引用都快速上升,圖中某啲交叉學科嘅曲線甚至喺2023–2024年間出現陡升。呢個趨勢代表越來越多年輕實驗室同跨學科團隊將預測結構直接納入實驗設計,推動高通量篩選同理性設計變得普及。
文章仲細緻交代AlphaFold喺實驗室工作流程入面嘅角色:對於冷門或難溶蛋白,研究者會用預測模型指導截短、突變同表達策略;喺低分辨率嘅冷凍電子顯微鏡(cryo‑EM)圖像處理過程,AlphaFold模型常做為初始模板,加速裝配同擬合。Nature嘅圖表用具體案例累積展示「模型→實驗驗證→功能發現」嘅閉環,點樣縮短由假設去到確證嘅時間窗。
但圖表亦揭示咗局限:涉及配體結合、翻譯後修飾、多蛋白複合體以及高度無定形區(intrinsically disordered regions)嘅預測上,AlphaFold嘅置信度仍然唔平均。文章用置信度評分(pLDDT)分佈圖指出,低置信區往往同功能相關嘅調節片段或相互作用界面重合,提示研究者喺呢啲區域仍然要靠實驗去驗證。
喺技術演進方面,Nature指出AlphaFold系列嘅擴展(例如AlphaFold Multimer等模組)正嘗試覆蓋複合體建模;同時,圖表顯示開源數據策略大幅降低咗獲取門檻,全球多個中低收入國家嘅研究機構開始喺本地樣本應用結構預測,促成更加多元化嘅生物學問題被納入研究範圍。
面向未來,圖表將重點放喺「可解釋性」同「動態性」:靜態三維座標雖然有價值,但蛋白質功能經常依賴構象振盪同相互轉換,文章建議下一步應將機器學習預測、分子動力學同高通量實驗更緊密結合,以捕捉功能相關嘅動力學景觀。此外,喺藥物靶點選擇同設計時點樣正確處理置信區間,並將預測結果同化學位點及配體資訊整合,亦都係接住要攻克嘅工程同算法問題。
總括嚟講,呢組圖表唔係單純頌揚一個工具,而係以可視化數據展示AlphaFold一方面帶嚟效率革命,另一方面亦暴露新嘅科學難題:開放嘅模型同數據庫將結構學門檻向世界各地年輕研究者打開,同時亦清晰劃定咗「需要實驗驗證嘅邊界」。對於搵緊下一個突破口嘅科研團隊同初創公司嚟講,AlphaFold既係加速器,亦係放大鏡——佢放大咗可被測嘅生物學問題,亦放大咗未解決嘅複雜性。