
長期以來,網站內容畀各家AI爬蟲反覆抓取用作模型訓練,已經成為內容發布方普遍面對嘅問題。由於OpenAI、谷歌、微軟、Anthropic等公司各自使用唔同嘅爬蟲標識(例如GPTBot、Google‑Extended、ClaudeBot等),站長如果想限制內容用於AI訓練,通常需要逐一喺robots.txt入面配置規則,操作繁複而且容易遺漏。
2026年10月30日前後,OpenAI、谷歌、微軟同Anthropic宣布,會共同支持一套新嘅統一標準,讓內容發布方可以通過單一信號,一次過向多間AI公司表明「拒絕將內容用於生成式AI訓練」嘅偏好。相關消息經多家媒體報道後,喺11月1日前後喺中文科技圈引起關注。
新標準如何運作
呢套機制由Anthropic負責標準事務嘅技術負責人Kevin Kelley向互聯網工程任務組(IETF)提交草案,核心係喺網站現有嘅robots.txt文件中加入一個共享嘅「策略令牌」(policy token)。
具體寫法示例如下:
text
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
當中,User‑Agent: __usage_ai‑training 係統一識別標識,Disallow: / 表示禁止全站內容用作訓練,Allow則可以針對特定目錄(例如新聞稿頁面)開放例外。支持該標準嘅AI公司喺識別到呢個信號後,會限制其相關爬蟲將對應內容用於生成式模型訓練。
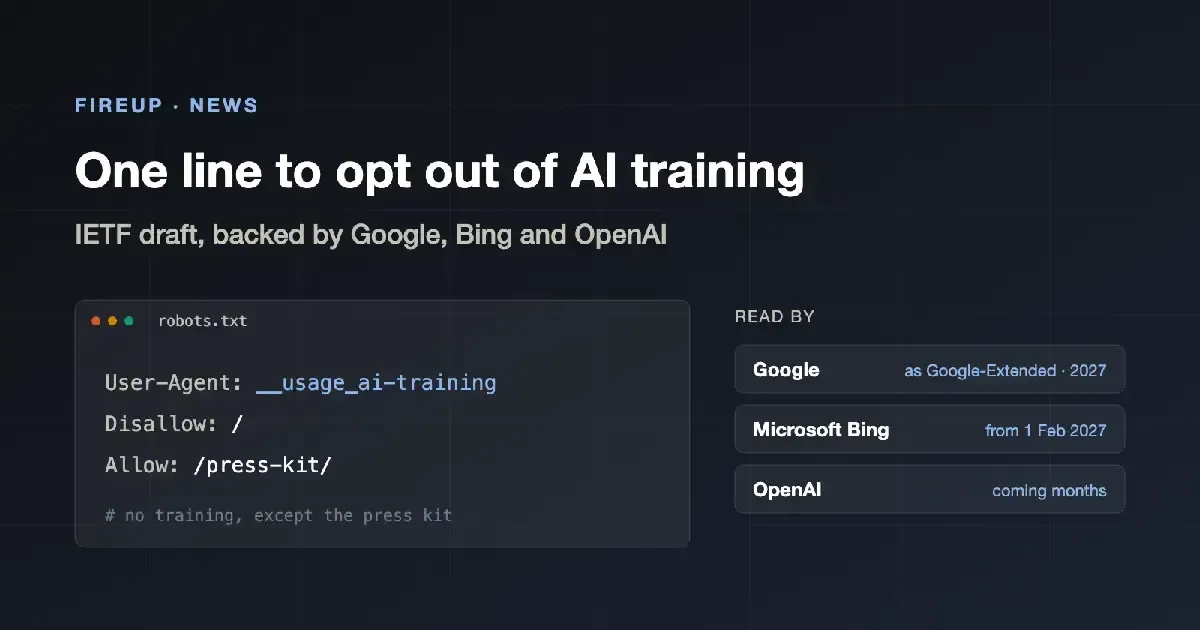
同以往逐家配置唔同,新標準旨在令發布方「一次設定、多方生效」。佢主要針對生成式AI訓練用途,一般唔會影響傳統搜尋引擎嘅正常索引(例如Googlebot、Bing爬蟲),網站仍然可以出現在常規搜尋結果中。微軟仲額外提供咗更細緻嘅控制,允許區分「訓練」與「AI grounding」(即模型引用驗證來源以降低幻覺),並強調相關設定唔會影響Bing搜尋可見性。
各公司落地時間表
目前各家推進節奏並唔一致:
- Anthropic已率先開始支持;
- OpenAI計劃喺未來幾個月內落地;
- 微軟明確將於2027年2月1日起支持;
- 谷歌則計劃喺2027年初支持,並會將其與現有嘅Google‑Extended控制機制銜接。
Meta相關負責人亦表示支持建立此類通用信號,但尚未公布具體落地時間。需要注意嘅係,該草案目前仍屬IETF個人提交嘅Internet‑Draft,並非已正式生效嘅互聯網標準,實際約束力仍然依賴各公司自願遵守。
意義與局限
呢一舉措被視為回應內容方長期抱怨嘅重要一步。此前,站長不得不持續跟蹤各家爬蟲名稱並單獨維護規則,管理成本較高。統一信號降低咗操作門檻,亦有助於將「是否允許用於AI訓練」嘅偏好,由企業間嘅雙邊約定,逐步推向更標準化、機器可讀嘅公共協議層。
不過,客觀嚟講,該標準仍有明顯邊界。首先,佢冇追溯效力,無法要求刪除或停止使用此前已被抓取並用於訓練嘅內容,只能約束標準生效後嘅新抓取行為。其次,佢主要針對生成式訓練場景,並唔全面禁止所有爬蟲訪問,搜尋索引、部分實時檢索等用途通常仍可繼續。此外,協議本身屬自願性質,尚未參與嘅其他AI公司或細規模爬蟲並唔受此約束。
對內容行業嚟講,呢更像係一次務實嘅流程優化,而非從根本上解決版權與數據使用爭議。未來,統一退出信號能否進一步擴展到更多公司、形成更廣泛嘅行業慣例,以及是否會同付費授權、內容許可等商業模式結合,仍有待觀察。
整體嚟講,OpenAI、谷歌、微軟同Anthropic共同支持統一AI訓練退出標準,標誌住頭部AI公司喺內容抓取規則上開始走向一定程度嘅協調。對網站管理者嚟講,呢提供咗一個更簡便嘅統一聲明方式;對整個行業而言,則係將數據使用偏好由碎片化管理,向標準化信號邁出嘅一步。實際效果如何,仍要睇後續落地進度同更多參與方嘅跟進情況。
▶️ 鍾意呢篇內容?創作真係好辛苦!
歡迎關注我哋嘅 YouTube 頻道:
AI Rosetta
你嘅讚好、訂閱同分享,係對我哋最大嘅支持!🙏
更多AI新聞請瀏覽:
https://www.airosetta.com