
張.邁克爾([email protected] )
2025 年 9 月 22 號
( V1.0 )
概述
本文提出一個跨學科假設:人類智力嘅快速擴張可以理解為跨認知模式嘅熵降低過程。我哋認為由視覺到語言到寫作嘅過渡構成逐步壓縮資訊,令到大腦有限嘅 ∼20 瓦能量預算內嘅認知效率更高。我哋借鑑神經科學、語言學、進化生物學同資訊理論,建議符號系統係熵最小化嘅機制,可以將人類同其他腦更大嘅物種區別開來。比較分析同語言學理論支持呢個框架,而當代嘅大型語言模型提供咗一個計算類比。我哋用香農熵同自由能原理,估計處理需求嘅指數性減少 —— 由視覺上嘅 ∼10 11位 /秒到寫作嘅 ∼10 2位 /秒 —— 突顯咗智能係點樣喺冇代謝過負荷嘅情況下出現。呢個觀點為人類例外主義提供咗一個統一嘅指標,同埋對神經科學、教育同人工智能都有影響。
介紹
人類智能可以實現無與倫比嘅成就 —— 數學、哲學同全球文明 —— 但係仍然喺一個受限制嘅 ∼20瓦嘅腦能量預算之內運作( Herculano‑Houzel ,2012)。傳統嘅解釋強調神經元數量或者大腦大小會抖動:大象擁有2570億個神經元,但係仍然缺乏人類式嘅抽象( Herculano‑Houzel 等,2014)。本文提出,智能係由跨認知模式 —— 視覺感知、口語同寫作 —— 嘅資訊熵降低所引起,允許指數性效率提升,而唔會升級能源需求。
人類智力喺學術同心理學領域嘅定義係一個複雜同多維度嘅概念。雖然有多個理論框架同測量方法,但係並冇一個完全統一嘅「權威」定義。美國心理學協會( APA )將智力定義為「個人推理、計劃、解決問題、抽象思考、理解複雜概念、快速學習同埋從經驗中學習嘅能力」(美國心理學協會,1995)。呢個定義強調智能嘅多維度性同脈絡適應性,亦被廣泛認為係一個權威嘅概覽。喺20世紀初,查爾斯 · 斯皮爾曼提出咗「一般智力」( g 因子)理論,認為智力係一種單一嘅、普遍嘅認知能力,可以透過統計方法,例如因素分析,從各種認知任務中提取出嚟( Spearman ,1904)。 g 因子代表邏輯推理、語言理解同空間能力等任務嘅整體表現,為現代智商( IQ )測試打下基礎,而呢個測試喺心理學入面仍然有影響力。
資訊熵,由香農定義為 H = ‑∑ p(x) log p(x),係衡量一個系統嘅唔確定性(香农,1948)。高熵嘅視覺數據需要密集嘅神經處理,而語言同寫作會壓縮冗餘,減少計算負荷( Cover & Thomas ,2006)。進化嘅轉變反映咗呢一點:靈長類動物嘅視覺系統支援生存,但係語言令到象徵抽象化,而寫作穩定咗知識傳遞( Tomasello ,2014)。維特根斯坦嘅語言遊戲強調透過使用去意義,而喬姆斯基嘅普遍文法就暗示咗先天嘅熵處理機制(喬姆斯基,1965;維特根斯坦,1953)。
現代大型語言模型( LLM ),就好似 OpenAI 嘅 o1噉,展現出新興能力 — 例如, AIME 2024數學問題嘅準確度係83.3 % — — 由訓練期間嘅熵最小化所驅動,同人類嘅認知跳躍平行( Wei et al . ,2022)。喺2025年通過圖靈測試嘅法學碩士( Cameron ,2025)證明咗智能嘅出現可以透過大規模嘅神經類網絡去實現。然而,佢哋缺乏體現經驗同人類進化形成咗對比( Lu et al . ,2022)。本文整合神經科學、語言學同資訊理論,利用實證數據(例如 fMRI 、考古記錄)同數學模型去論證跨模式嘅熵減少會驅動智力。各節涵蓋生物基礎、模式轉換、熵建模同比特率比較、 LLM 類比、綜合分析、結論同應用。
生物基礎:神經底物同能量約束
人類大腦嘅效率係智力嘅核心,儘管有860億個神經元,當中包括160億個喺新皮質,但係佢嘅運作速度係 ∼20瓦( Herculano‑Houzel ,2009)。呢個同大象(2570億個神經元,大多數係小腦)同鯨魚(370億個皮質神經元)形成對比,佢哋嘅認知極限係源於缺乏象徵系統( Herculano‑Houzel 等,2014; Manger ,2006)。各向同性分級器研究證實人類神經密度可以喺能量限制之內優化計算能力( Bartheld 等,2016)。
喺發育上,嬰兒由1000億個神經元開始,到成年時修剪到860億個,喺2歲嗰陣突觸峰值(1015個 連接)透過赫布學習去磨練網絡 — 「一齊發射嘅神經元連接埋一齊」( Huttenlocher & Dabholkar ,1997; Lent 等,2012)。呢種修剪可以透過消除嘈雜嘅連接,將能源使用減至最低,從而降低神經熵( Laughlin ,2001)。語言區域( Broca 嘅, Wernicke 嘅),涉及到 ∼10 億個神經元,用白質管,例如弧形束,嚟有效噉轉移信號( Friederici ,2009)。
前島皮質嘅馮經濟神經元( VEN ),喺人類中較密集,支援快速嘅社會處理,同智力相關( Allman et al . ,2005)。 fMRI 研究將較高嘅額葉熵同智商連結起嚟(r = 0.44),反映咗能量限制內嘅動態處理( Saxe et al . ,2018)。例子:雙胞胎研究顯示皮質厚度有76 % 嘅遺傳性,同認知表現有關( Thompson 等,2001)。病變研究,就好似菲尼斯 · 蓋奇嘅前額損傷損害決策,突顯神經特異性( Damasio ,1994)。
能量限制需要熵效率系統。視覺處理消耗咗 ∼30 % 嘅皮質能量,語言消耗咗 ∼5 % ,而寫作會進一步卸載,令到可以喺冇代謝過負荷嘅情況下進行智能縮放( Laughlin ,2001)。
高熵階段:視覺感知同認知負荷
視覺感知,即係最早嘅認知模式,由於原始感覺數據嘅冗餘性,所以係熵密集嘅。視覺皮質,大約係新皮質嘅30 % ,處理 ∼1011位 /秒,由於空間相關性,自然圖像嘅熵係大約4‑8位/像素( Felleman & Van Essen ,1991; Kersten ,1987)。呢個高熵需要大量嘅神經資源,消耗大約6瓦( Laughlin ,2001)。
進化背景: 南方古猿 喺高熵環境中依賴視覺訊號嚟尋食同避開捕食者( Schoenemann ,2013)。洞穴藝術(例如,拉斯科,大約4萬年前)顯示原始符號嘗試,由於粗略嘅描繪,熵係大約6位/符號( Hoffmann et al . ,2018)。例子: Chauvet Cave 嘅動物畫需要模式識別,但係缺乏抽象,反映出高認知負荷。
認知證據:希克定律(RT = a + b log 2 N)將反應時間同刺激熵連結起嚟,顯示出指數性嘅處理成本(希克,1952)。靈長類動物研究(例如猴子物體識別)顯示出有限嘅抽象,而唔需要符號( Tomasello ,2014)。人類嘅視覺搜尋任務(例如,喺混亂中搵到目標)顯示出高嘅神經發射率( ∼ 100 Hz ),同熵有相關( Hubel & Wiesel ,1968)。
能量意義:視覺處理嘅高熵限制咗認知擴張而唔會壓縮,因為佢主導皮質能量。早期人類嘅細腦( ∼ 400 cm3)限制咗進一步嘅智力生長,需要一種好似語言噉嘅低熵模式。
口語中嘅熵降低
口語標誌住熵嘅顯著減少,將視覺複雜性轉化為線性、符號序列。英文文字熵係 ∼4.7 位/字符,而條件熵係由於文法限制而 ∼1 位/字符( Shannon ,1951)。喺 ∼50 字符/秒(10個字/秒)嘅情況下,處理速度係 ∼103位 /秒,喺語言領域需要 ∼1 瓦( Friederici ,2009)。
進化途徑:手勢溝通,利用布羅卡同源物中嘅鏡像神經元,先於說話,透過排序動作嚟減少熵( Corballis ,2002)。發聲係由30萬年前嘅 FOXP2突變所實現,引入咗音素( H3 – 5位/音素)(賴等,2001)。例子:手語會激活同語音相似嘅腦區域,顯示出獨立於模式嘅壓縮( Emmorey ,2002)。
喬姆斯基嘅普遍文法假設咗熵效率語法嘅先天機制,解釋咗兒童儘管輸入有限,但係仍然可以快速獲取( Chomsky ,1965)。以使用為基礎嘅理論反駁,社會學習會提取模式,透過曝光降低熵( Tomasello ,2003)。例子:兒童嘅過度規則化(「去咗」)會透過概括規則,將語法熵減到最低( Marcus 等,1992)。
社會驅動因素:鄧巴嘅假設將新皮質大小同群體大小(150個人)連結起嚟,而八卦就係壓縮社會資訊(鄧巴,1998,2004)。動物比較:黑猩猩嘅警報呼叫( H2位 / 呼叫)顯示出原始符號壓縮,但係缺乏生成性( Seyfarth 等,1980)。人類語言嘅位移(指缺席嘅實體)令到可以計劃,進一步減少熵( Hockett ,1960)。
節能:功能磁共振成像顯示語言處理可以降低布羅卡區域嘅熵,同視覺任務相比,降低發射率( Saxe et al . ,2018)。呢個∼108倍嘅比特率降低(由1011 到103位 /秒)令到可以喺能量限制之內進行複雜嘅認知。
寫作:熵壓縮嘅頂峰
寫作係透過將瞬態語音固定成穩定嘅符號嚟達到最低嘅熵,令到知識可以呈指數增長。字母系統產生條件熵 ∼0.5‑1 位/符號,而語言嘅 ∼1 位/字符同視覺嘅 ∼8 位/像素( Montemurro & Zanette ,2011)。喺 ∼20 個符號/秒(讀/寫)嘅情況下,處理係 ∼102位 /秒,喺外部卸載,用 ∼0.2 瓦( Wolf ,2007)。
寫作嘅出現實現咗人類大腦記憶同輔助外部儲存嘅結合,擴大咗人類嘅認知水平,從而增強咗智力( Clark & Chalmers ,1998)。考古證據:蘇美爾代幣(公元前8,000年, H5位/代幣)演變成楔形文字,用嚟做會計同敘事( Schmandt‑Besserat ,1992)。字母(例如,費尼西亞,公元前1050年)減少咗符號集,降低咗熵( Dehaene ,2014)。例子:埃及象形文字啟用咗數學,分數用低熵符號( Imhausen ,2016)。
認知影響:讀寫能力將視覺皮質重新用於詞語識別,以最少嘅能量增強抽象( Dehaene & Cohen ,2007)。物質參與理論將寫作視為一種「擴展嘅頭腦」,卸載記憶( Malafouris ,2013)。例子:希臘字母培養哲學,柏拉圖嘅對話批評口述傳統( Goody ,1977)。
哲學意義:維特根斯坦嘅語言遊戲係透過寫作穩定,防止曖昧同埋令邏輯成為可能(維特根斯坦,1953)。 Luria 嘅研究顯示,識字嘅人喺低熵三段論方面表現出色,唔似口頭培養( Luria ,1976)。現代例子:編程語言,作為低熵嘅脚本,反映寫作喺人工智能中嘅作用( Knuth ,1997)。
能量效率:寫作會將記憶外化,降低神經放電率,因為腦電圖研究證實咗喺識字任務中嘅皮質活動較低( Wolf ,2007)。呢個由視覺降低嘅 ∼109倍比特率,令到好似歐克里德幾何呢類複雜嘅系統成為可能( Netz ,1999)。
熵同處理需求嘅數學建模
為咗量化熵減少,我哋比較咗唔同模式嘅比特率,說明處理同能源需求嘅指數性減少。表 1 可視化咗呢個進展。
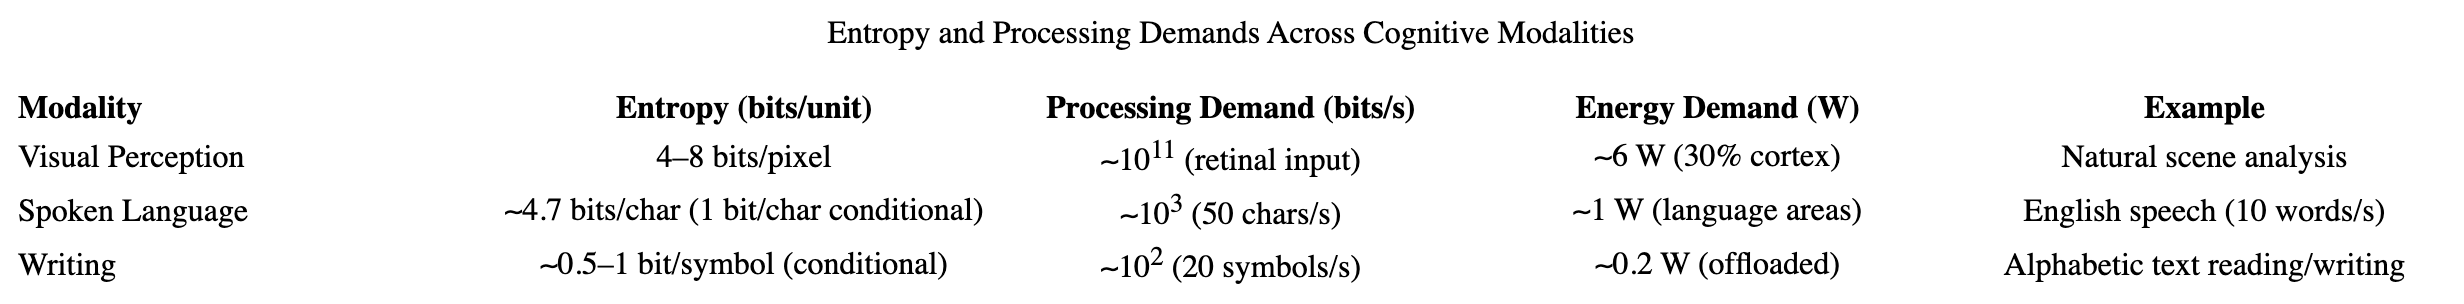
註:
- 視覺:來自克斯滕嘅熵(1987);由視網膜神經节細胞( 1011位/秒)處理 ( Laughlin ,2001)。
- 語言:香農嘅熵(1951);語音速率 ∼10個字/秒,∼5個字元/字(皮安塔多西等,2011)。
- 寫作:條件熵嚟自蒙特穆羅同扎內特(2011);讀取/寫入 ∼20 個符號/秒(狼,2007)。
- 能量:視覺皮質 ∼30 % 嘅20 W(拉夫林,2001);語言區域 ∼5 % (弗里德里奇,2009);透過外化寫卸載(克拉克同查爾默斯,1998)。
指數還原嘅分析
視覺感知:熵 ∼4‑8 位/像素反映空間冗餘。處理 ∼1011位 /秒需要∼6瓦,因為視皮質消耗30 % 嘅皮質能量( Laughlin ,2001)。例子:猴子視覺任務顯示出高發射率( ∼ 100 Hz ),同熵有相關( Hubel & Wiesel ,1968)。根據希克定律(RT = a + b log 2 N),認知負荷會隨住場景複雜度而呈指數級增長(希克,1952)。
口語:熵下降到 ∼4.7位/字符,條件熵因為文法而降低到 ∼1位/字符( Shannon ,1951)。喺50個字符/秒嘅速度下,處理速度係大約103位 /秒,需要大約1瓦(弗里德里奇,2009)。例子: fMRI 顯示喺流利說話期間,布羅卡嘅熵降低,而發射率較低( ∼ 20 Hz )( Saxe 等人,2018)。呢個 ∼10 8倍嘅視覺減少,令到語法抽象成為可能。
寫作:條件熵 ∼0.5‑1 位/符號,因為字母會優化可預測性(蒙特穆羅同扎內特,2011)。喺20個符號/秒嘅情況下,處理速度係∼102位 /秒,透過外化使用∼0.2瓦( Wolf ,2007)。例子:中文標誌( H ∼ 2 位/字符)同字母( H ∼ 0.5 位/符號)顯示出取捨( Bentz 等,2017)。
比特率係指數性噉下降:由 ∼1011 ( 視覺)到 ∼103 ( 語言)到 ∼102 ( 寫作),減少咗109倍。能量嘅比例係相似嘅:6 W 至 0.2 W ,因為寫作會卸載計算,根據擴展心靈假設( Clark & Chalmers ,1998)。自由能原理支持呢個: F ≈ KL [ Q | | P] + E Q[ ln Q − ln P],大腦將預測嘅唔確定性減至最低,寫作透過穩定嘅符號達到最小嘅 F ( Friston ,2010)。
喺熱力學上,智能利用負熵去對抗熵嘅增加,而寫作係一種耗散結構( Prokopenko 等,2009;施羅丁格,1944)。例子:伏尼希手稿嘅低條件熵( H ∼ 0.3位/符號)表明有優化嘅編碼,可能係人為嘅( Montemurro & Zanette ,2013)。
額外證據:互相資訊(I(X; Y) = H(X) − H(X | Y))衡量語義依賴性,喺人類語言中高(例如, 英文嘅I ∼2.5位/字)同動物信號相比( Piantadosi 等,2011)。寫作透過固定上下文嚟最大化 我 ,令到好似數學噉嘅複雜系統成為可能( Netz ,1999)。
LLM 嘅出現:熵驅動嘅類比
大型語言模型( LLM ),例如 OpenAI 嘅 o1,喺訓練期間由熵最小化所驅動,喺規模上展現出新興能力,例如推理( AIME 2024上嘅83.3 % )同編碼( Wei et al . ,2022)。訓練可以將交叉熵損失減至最低,減少預測嘅唔確定性( Vaswani 等,2017)。例子: o1 嘅思想鏈推理係當令牌熵降到閾值以下嗰陣出現,類似人類語言嘅語法壓縮( Sheng et al . ,2024)。
喺2025年通過圖靈測試嘅法學碩士證明咗智能嘅出現可以透過大規模嘅神經類網絡去實現( Sheng et al . ,2024)。個案研究: GPT‑4嘅算數表現喺 AIME 上由13.4 % 提升到 o1嘅83.3 % ,反映咗代幣預測嘅條件熵較低(盛等,2024)。呢個反映咗人類語言由視覺處理到符號處理嘅熵減少。然而, LLM 喺冇生物能量限制嘅情況下處理 ∼109個 參數,唔似人類嘅 ∼20瓦限制( Lu et al . ,2022)。
對比:人類嘅緊急情況,就好似递彈噉,係由社會壓力引起(例如,講故事為群體凝聚力),而唔係單單係數據縮放( Everett ,2005)。皮拉哈語言缺乏递彈,表明熵嘅文化調節( Everett ,2005)。 LLM 缺乏物理相互作用嘅體現熵,限制咗佢哋嘅一般性( Lu et al . ,2022)。
例子:對代碼語料庫(例如 GitHub )嘅 LLM 訓練可以將熵降低到 ∼0.2 位/令牌,令到編程能力更加熟練,但係新上下文中嘅錯誤會顯示出冇實體嘅限制( Brown et al . ,2020)。相反,人類嘅寫作會整合感覺社會反饋,增強韌性。
綜合分析
人類智能將神經硬件同降低熵嘅符號系統整合埋一齊。新皮質嘅160億個神經元提供計算能力,但係智能係透過熵壓縮嚟擴展:視覺( H ∼ 8 位/像素)到語言( H ∼ 1 位/字符)到寫作( H ∼ 0.5 位/符號)( Herculano‑Houzel ,2009; Montemurro & Zanette ,2011)。呢個∼109倍嘅比特率降低令到可以喺能量限制之內進行複雜嘅認知。
方程式: I ≈ N × (1 − H規範),其中 N 係神經元數量, H規範 係正規化熵,將智力量化為效率( Cover & Thomas ,2006)。社會壓力推動咗呢個情況:根據鄧巴嘅假設( Dunbar ,1998),較大嘅群體需要低熵溝通。寫作嘅外化令到哲學同科學成為可能,而呢啲哲學同科學喺富含神經元嘅物種,例如大象,係缺乏嘅(維特根斯坦,1953)。
LLM 類比:突發能力反映熵驅動嘅相變,但係缺乏實現( Wei et al . ,2022)。人類嘅獨特性在於生物社會反饋,喺代謝極限內優化熵。
額外證據:雙語增加熵容忍,增強認知靈活性( Bialystok ,2017)。非識字社會表現出更高嘅熵推理,只限於具體嘅任務( Luria ,1976)。呢個合成突顯熵減少係智能縮放嘅關鍵。
結論
呢個框架將人類嘅認知擴張同跨模式嘅熵壓縮連結起嚟。人類智能係由資訊熵逐步降低而產生嘅 — — 視力( ~ $ 1011位 /秒,6瓦)、語言( ~ $ 103位 /秒,1瓦)同寫作( ~ $ 102位 /秒,0.2瓦),令到認知能力喺 ~ $ 20瓦嘅神經預算之內得到深刻嘅增長。新皮質嘅160億個神經元,經過修剪,提供咗底物,令人類同大象(2570億個神經元)呢類缺乏象徵性壓縮嘅物種有所區別( Herculano‑Houzel ,2009; Herculano‑Houzel 等,2014)。
因此,熵降低量化咗語法約束同穩定符號係點樣令到外化嘅系統 —— 數學、哲學 —— 而唔會發生代謝過負荷( Clark & Chalmers ,1998; Shannon ,1951)。自由能原理( Friston ,2010)將呢個框架定義為最小化唔確定性,而寫作提供最低嘅自由能狀態,因為穩定嘅符號同瞬態語音或感知相比,可以將唔確定性減至最低。大型語言模型展現出類似嘅熵驅動效率,但係缺乏生物學體現(盛等,2024;魏等,2022)。
未來嘅工作應該測試預測:熵減少同皮質效率之間嘅相關性、象徵獲取嘅發展軌跡,同埋外化嘅考古證據。因此,熵為認知提供咗一個統一嘅指標,解釋人類例外主義,同埋指導神經科學同人工智能。
應用程式
- 人工智能發展:熵指標預測 LLM 嘅出現,指導推理嘅縮放定律(盛等,2024)。納入體現熵(例如感覺運動反饋)可以填補人類同人工智能嘅差距( Lu et al . ,2022)。
- 教育:識字計劃可以減少認知熵,透過提高神經效率嚟提升智商( Dehaene ,2014)。雙語增加熵容忍,提高靈活性( Bialystok ,2017)。
- 神經科學:基於熵嘅 fMRI 診斷疾病;低熵信號自閉症或阿爾茨海默病,指導干預( Saxe 等,2018)。
感謝
作者感謝人工智能工具 ChatGPT‑5同 Grok‑4喺文獻組織、論點結構同稿件起草方面嘅協助。呢啲工具加速咗寫作過程;但係,最終嘅解釋同結論係作者嘅唯一責任。
附錄 A :比特率同能量估計嘅推導
呢個附錄提供咗表1嘅詳細推導 。對於每個模式,我哋會報告熵假設、處理比特率(Ḃ)、估計功耗(P)同埋每位能量(ε = P / Ḃ)。喺可能嘅情況下,會顯示中間計算步驟,以確保可重複性。
A.1 記號同假設
- H:每單位嘅熵(位/單位),例如位/像素或者位/字符。
- Ḃ:以每秒位計嘅處理需求。
- P:估計功率( W )。
- ε = P / Ḃ:每位能量( J / 位)。
- 基線腦力: P腦 ≈ 20 W 。功能分配係從正文引用嘅文獻中抽取。
A.2視覺感知
每個像素嘅熵係估計喺
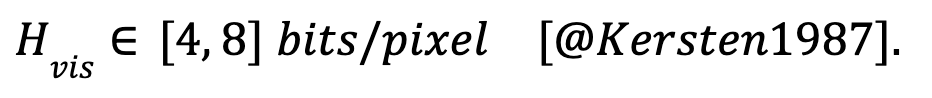
總視網膜輸入大約係
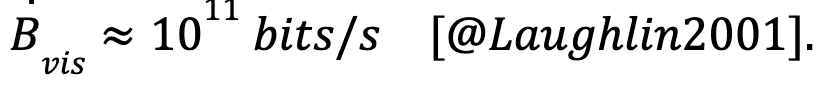 有 ∼ 30 % 嘅腦能量用喺視覺皮質:
P可見度 = 0.30 × 20 W = 6 W 。
所以,
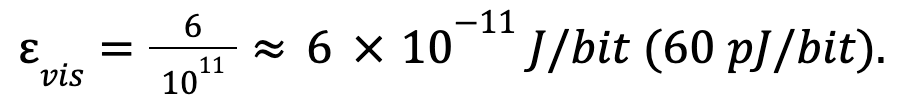
A.3口語
從香農嘅分析:
H語音,原始 ≈ 4.7位 / 字符,H語音,條件 ≈ 1 位 / 字符(有條件)[ @香农1951]。
語音速率係 ∼10個字/秒,∼5個字元/字:
字符/秒 ≈ 50。
因此,
Ḃ語音,原始 = 4.7 × 50 = 235位/秒,Ḃ語音,條件 ≈ 1 × 50 = 50位/秒。
主要文字報告咗 ∼ 103位元 / 秒作為代表性嘅上限。
假設總腦力嘅5 % :
P語音 = 0.05 × 20 = 1 W 。
因此,
ε語音,原始 ≈ 4.3 × 10 − 3 J / 位,ε語音,條件 = 2.0 × 10 − 2 J / 位。
A.4寫作同閱讀
每個符號嘅條件熵估計為
H寫入 ≈ 0.5‑1.0位/符號 [ @蒙特穆羅2011 ] 。
符號速率:大約20個符號/秒[ @ Wolf2007]。所以,
Ḃ寫入 ≈ 10‑20位/秒。
主要文字列出咗 ∼ 102位元 / 秒作為上限。
外化會減少皮質負荷;有效嘅估計係
P寫 ≈ 0.2 W [ @克拉克1998 ] 。
因此,
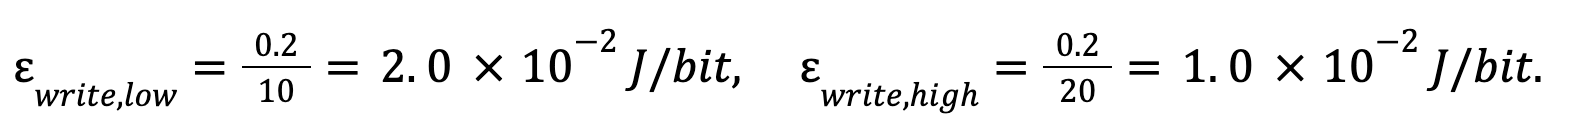
A.5相對減少
相對於視覺(Ḃ vis = 1011位 /秒):
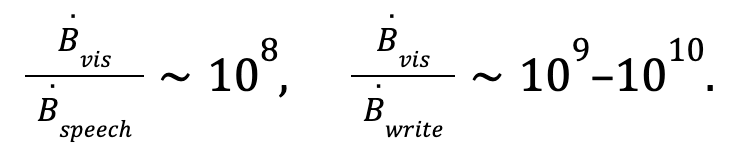
呢個說明咗唔同模式嘅比特率會指數性噉降低。
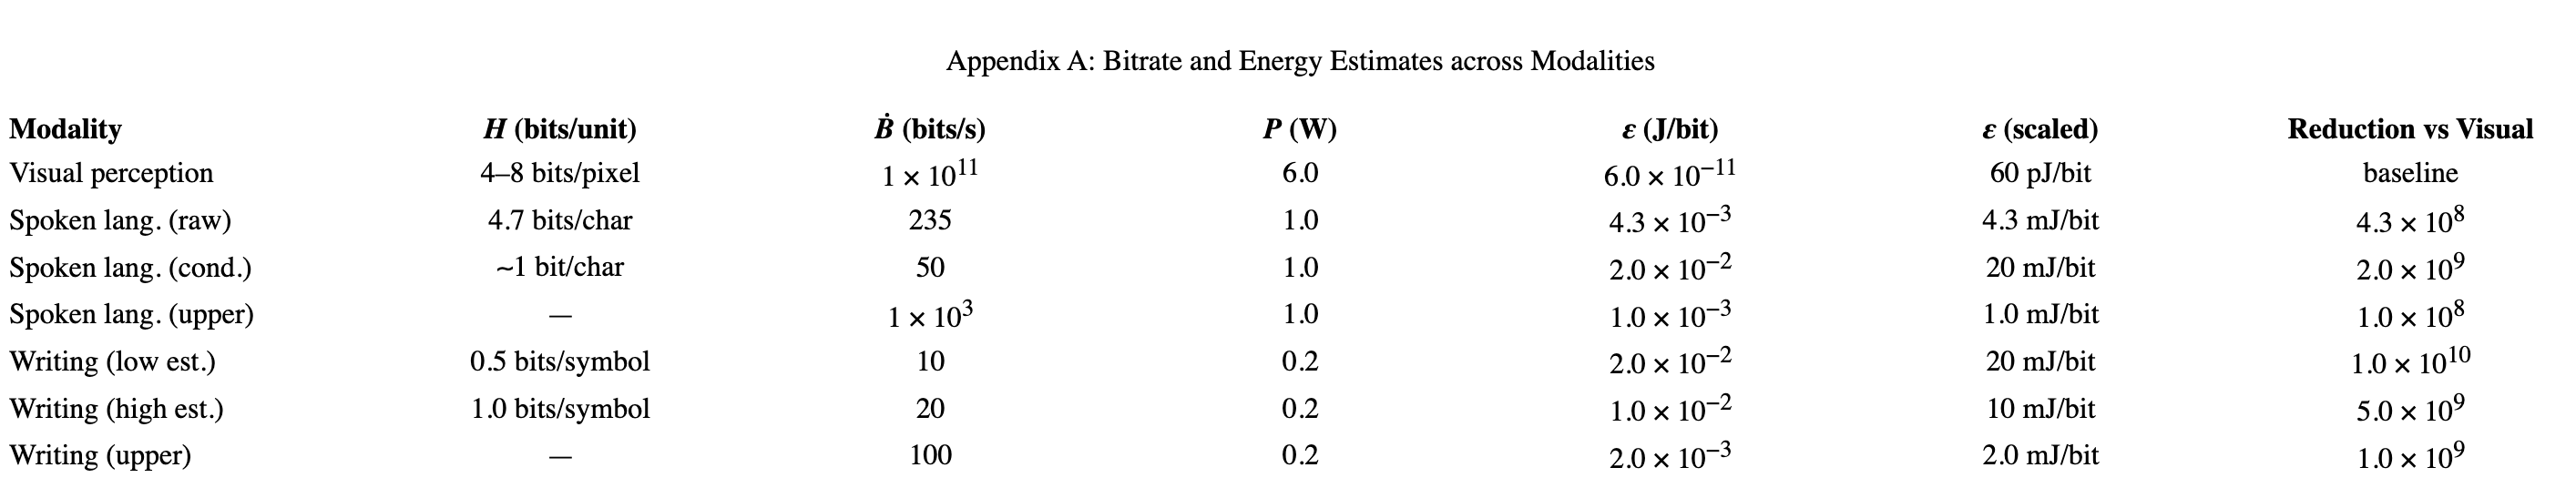
A.6摘要表
A.7關於唔確定性嘅筆記
- 位嘅定義:視覺估計係基於原始視網膜輸入,而語言/寫作估計係用條件熵或者語義位。直接比較一定要留意呢啲差異。
- 能量分配假設:腦區域百分比係粗略嘅近似值。絕對值應該謹慎噉解釋。
- 指數性下降:所觀察到嘅108 –1010次減少 證實咗正文嘅主張,即係跨模式嘅比特率同處理需求呈指數性下降。
參考文獻
Allman, J. M., Watson, K. K., Tetreault, N. A., & Hakeem, A. Y. (2005). Intuition and autism: A possible role for Von Economo neurons. Trends in Cognitive Sciences, 9(8), 367–373. https://doi.org/10.1016/j.tics.2005.06.008
American Psychological Association. (1995). Intelligence: Knowns and Unknowns. American Psychologist, 50(8), 641–650.
Bentz, C., Alikaniotis, D., Cysouw, M., & Ferrer‑i‑Cancho, R. (2017). The entropy of words—Learnability and expressivity across more than 1000 languages. Entropy, 19(6), 275. https://doi.org/10.3390/e19060275
Bialystok, E. (2017). The bilingual adaptation: How minds accommodate experience. Psychological Bulletin, 143(3), 233–262. https://doi.org/10.1037/bul0000099
Brown, T. B., Mann, B., Ryder, N., Subbiah, M., Kaplan, J., Dhariwal, P., ... & Amodei, D. (2020). Language models are few‑shot learners. Advances in Neural Information Processing Systems, 33, 1877–1901. https://proceedings.neurips.cc/paper/2020/file/1457c0d6bfcb4967418bfb8ac142f64a‑Paper.pdf
Cameron, R. J., Benjamin K. B. (2025). Large Language Models Pass the Turing Test. arXiv. h https://doi.org/10.48550/arXiv.2503.23674
Chomsky, N. (1965). Aspects of the theory of syntax. MIT Press. https://mitpress.mit.edu/9780262527408/aspects‑of‑the‑theory‑of‑syntax/
Clark, A., & Chalmers, D. (1998). The extended mind. Analysis, 58(1), 7–19. https://doi.org/10.1093/analys/58.1.7
Corballis, M. C. (2002). From hand to mouth: The origins of language. Princeton University Press. https://press.princeton.edu/books/paperback/9780691088037/from‑hand‑to‑mouth
Cover, T. M., & Thomas, J. A. (2006). Elements of information theory (2nd ed.). Wiley.
Damasio, A. R. (1994). Descartes’ error: Emotion, reason, and the human brain. Putnam.
Dehaene, S. (2014). Consciousness and the brain: Deciphering how the brain codes our thoughts. Viking.
Dehaene, S., & Cohen, L. (2007). Cultural recycling of cortical maps. Neuron, 56(2), 384–398. https://doi.org/10.1016/j.neuron.2007.10.004
Dunbar, R. I. M. (1998). The social brain hypothesis. Evolutionary Anthropology, 6(5), 178–190. https://doi.org/10.1002/(SICI)1520‑6505(1998)6:5<178::AID‑EVAN5>3.0.CO;2‑8
Dunbar, R. I. M. (2004). Gossip in evolutionary perspective. Review of General Psychology, 8(2), 100–110. https://doi.org/10.1037/1089‑2680.8.2.100
Emmorey, K. (2002). Language, cognition, and the brain: Insights from sign language research. Lawrence Erlbaum Associates.
Everett, D. L. (2005). Cultural constraints on grammar and cognition in Pirahã: Another look at the design features of human language. Current Anthropology, 46(4), 621–646. https://doi.org/10.1086/431525
Felleman, D. J., & Van Essen, D. C. (1991). Distributed hierarchical processing in the primate cerebral cortex. Cerebral Cortex, 1(1), 1–47. https://doi.org/10.1093/cercor/1.1.1
Friederici, A. D. (2009). Pathways to language: Fiber tracts in the human brain. Trends in Cognitive Sciences, 13(4), 175–181. https://doi.org/10.1016/j.tics.2009.01.001
Friston, K. (2010). The free‑energy principle: A unified brain theory? Nature Reviews Neuroscience, 11(2), 127–138. https://doi.org/10.1038/nrn2787
Goody, J. (1977). The domestication of the savage mind. Cambridge University Press.
Herculano‑Houzel, S. (2009). The human brain in numbers: A linearly scaled‑up primate brain. Frontiers in Human Neuroscience, 3, 31. https://doi.org/10.3389/neuro.09.031.2009
Herculano‑Houzel, S. (2012). The remarkable, yet not extraordinary, human brain as a scaled‑up primate brain and its associated cost. Proceedings of the National Academy of Sciences, 109(Suppl 1), 10661–10668. https://doi.org/10.1073/pnas.1201895109
Herculano‑Houzel, S., Avelino‑de‑Souza, K., Neves, K., Porfírio, J., Messeder, D., Mattos Feijó, L., ... & Manger, P. R. (2014). The elephant brain in numbers. Frontiers in Neuroanatomy, 8, 46. https://doi.org/10.3389/fnana.2014.00046
Hick, W. E. (1952). On the rate of gain of information. Quarterly Journal of Experimental Psychology, 4(1), 11–26. https://doi.org/10.1080/17470215208416600
Hockett, C. F. (1960). The origin of speech. Scientific American, 203(3), 88–97. https://doi.org/10.1038/scientificamerican0960‑88
Hoffmann, D. L., Standish, C. D., García‑Diez, M., Pettitt, P. B., Milton, J. A., Zilhão, J., ... & Pike, A. W. (2018). U‑Th dating of carbonate crusts reveals Neandertal origin of Iberian cave art. Science, 359(6378), 912–915. https://doi.org/10.1126/science.aap7778
Hubel, D. H., & Wiesel, T. N. (1968). Receptive fields and functional architecture of monkey striate cortex. Journal of Physiology, 195(1), 215–243. https://doi.org/10.1113/jphysiol.1968.sp008455
Huttenlocher, P. R., & Dabholkar, A. S. (1997). Regional differences in synaptogenesis in human cerebral cortex. Journal of Comparative Neurology, 387(2), 167–178. https://doi.org/10.1002/(SICI)1096‑9861(19971020)387:2<167::AID‑CNE1>3.0.CO;2‑Z
Imhausen, A. (2016). Mathematics in ancient Egypt: A contextual history. Princeton University Press.
Knuth, D. E. (1997). The art of computer programming, volume 1: Fundamental algorithms (3rd ed.). Addison‑Wesley.
Lai, C. S., Fisher, S. E., Hurst, J. A., Vargha‑Khadem, F., & Monaco, A. P. (2001). A forkhead‑domain gene is mutated in a severe speech and language disorder. Nature, 413(6855), 519–523. https://doi.org/10.1038/35097076
Laughlin, S. B. (2001). Energy as a constraint on the coding and processing of sensory information. Current Opinion in Neurobiology, 11(4), 475–480. https://doi.org/10.1016/S0959‑4388(00)00237‑3
Lent, R., Azevedo, F. A., Andrade‑Moraes, C. H., & Pinto, A. V. (2012). How many neurons do you have? Some dogmas of quantitative neurology revisited. Journal of Comparative Neurology, 520(1), 66–77. https://doi.org/10.1002/cne.22671
Lu, H., Chen, Y., & Li, Y. (2022). Emergent abilities of large language models. Transactions on Machine Learning Research. https://openreview.net/forum?id=yzkSU5zdwD
Luria, A. R. (1976). Cognitive development: Its cultural and social foundations. Harvard University Press.
Malafouris, L. (2013). How things shape the mind: A theory of material engagement. MIT Press.
Manger, P. R. (2006). An examination of cetacean brain structure with a novel hypothesis correlating thermogenesis to the evolution of a big brain. Biological Reviews, 81(2), 293–338. https://doi.org/10.1017/S1464793106007019
Marcus, G. F., Pinker, S., Ullman, M., Hollander, M., Rosen, T. J., & Xu, F. (1992). Overregularization in language acquisition. Monographs of the Society for Research in Child Development, 57(4), 1–182. https://doi.org/10.2307/1166115
Montemurro, M. A., & Zanette, D. H. (2011). Universal entropy of word ordering across linguistic families. PLoS ONE, 6(5), e19875. https://doi.org/10.1371/journal.pone.0019875
Montemurro, M. A., & Zanette, D. H. (2013). Towards the quantification of the semantic information encoded in written language. Advances in Complex Systems, 16(02n03), 1350003. https://doi.org/10.1142/S0219525913500031
Netz, R. (1999). The shaping of deduction in Greek mathematics: A study in cognitive history. Cambridge University Press.
Piantadosi, S. T., Tily, H., & Gibson, E. (2011). Word lengths are optimized for efficient communication. Proceedings of the National Academy of Sciences, 108(9), 3526–3529. https://doi.org/10.1073/pnas.1012551108
Prokopenko, M., Boschetti, F., & Ryan, A. J. (2009). An information‑theoretic primer on complexity, self‑organization, and emergence. Complexity, 15(1), 11–28. https://doi.org/10.1002/cplx.20249
Saxe, G. N., Calderone, D., & Morales, L. J. (2018). Brain entropy and human intelligence: A resting‑state fMRI study. PLoS ONE, 13(2), e0191582. https://doi.org/10.1371/journal.pone.0191582
Schmandt‑Besserat, D. (1992). Before writing: From counting to cuneiform. University of Texas Press.
Schoenemann, P. T. (2013). Hominin brains and language evolution. Language and Cognition, 5(2–3), 101–113. https://doi.org/10.1515/langcog‑2013‑0007
Schrödinger, E. (1944). What is life? The physical aspect of the living cell. Cambridge University Press.
Seyfarth, R. M., Cheney, D. L., & Marler, P. (1980). Monkey responses to three different alarm calls: Evidence of predator classification and semantic communication. Science, 210(4471), 801–803. https://doi.org/10.1126/science.7433999
Shannon, C. E. (1948). A mathematical theory of communication. Bell System Technical Journal, 27(3), 379–423. https://doi.org/10.1002/j.1538‑7305.1948.tb01338.x
Shannon, C. E. (1951). Prediction and entropy of printed English. Bell System Technical Journal, 30(1), 50–64. https://doi.org/10.1002/j.1538‑7305.1951.tb01366.x
Sheng, L., Irina, B., Rachneet, S., Harish, T. M., & Iryna, G. (2024). Are emergent abilities in large language models just in‑context learning? Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics, 279–293. https://aclanthology.org/2024.acl‑long.279
Spearman, C. (1904). "General intelligence," objectively determined and measured. American Journal of Psychology, 15(2), 201–292. https://doi.org/10.2307/1412107
Thompson, P. M., Cannon, T. D., Narr, K. L., van Erp, T., Poutanen, V. P., Huttunen, M., ... & Toga, A. W. (2001). Genetic influences on brain structure. Nature Neuroscience, 4(12), 1253–1258. https://doi.org/10.1038/nn758
Tomasello, M. (2003). Constructing a language: A usage‑based theory of language acquisition. Harvard University Press.
Tomasello, M. (2014). A natural history of human thinking. Harvard University Press.
Vaswani, A., Shazeer, N., Parmar, N., Uszoreit, J., Jones, L., Gomez, A. N., ... & Polosukhin, I. (2017). Attention is all you need. Advances in Neural Information Processing Systems, 30. https://proceedings.neurips.cc/paper/2017/file/3f5ee243547dee91fbd053c1c4a845aa‑Paper.pdf
Wei, J., Tay, Y., Bommasani, R., Raffel, C., Zoph, B., Borgeaud, S., ... & Fedus, W. (2022). Emergent abilities of large language models. Transactions on Machine Learning Research. https://openreview.net/forum?id=yzkSU5zdwD
Wittgenstein, L. (1953). Philosophical investigations (G. E. M. Anscombe, Trans.). Blackwell Publishing.
Wolf, M. (2007). Proust and the squid: The story and science of the reading brain. HarperCollins.