
近年嚟,人工智能(AI)以前所未有嘅速度改變全球科技產業。以大語言模型(LLM)為代表嘅生成式AI,正由實驗室走向產業實踐,並逐步滲透到軟件開發、科學研究、醫療診斷、金融服務、自動駕駛同智能製造等範疇。由ChatGPT到多模態模型,由AI Agent到世界模型,今日嘅人工智能已經唔再局限於單一算法或應用場景,而係逐漸形成涵蓋模型、算力、數據同應用嘅完整技術體系。
然而,呢場變革並非一蹴而就。今日嘅AI技術係建立喺過去數十年累積嘅基礎研究之上。一啲睇似已經成為基礎設施嘅算法同技術,例如ResNet、Adam、Transformer、BERT、U‑Net同Scikit‑learn,實際上都源自具有里程碑意義嘅學術論文。佢哋唔單只推動咗算法本身嘅突破,仲改變咗後續研究方向同產業技術路線。
本網站曾於2025年6月發表《2025年AI領域十大高被引論文全解析:深度學習與生成模型的里程碑》,介紹當時引用量較高嘅十篇AI論文。經過一年多發展,我哋重新審視呢啲經典研究,並結合截至2026年11月可獲取嘅最新引文數據,對其影響力作出更新。
需要說明嘅係,論文引用量冇一個全球統一嘅統計口徑。唔同嘅統計途徑例如Google Scholar、Semantic Scholar同其他學術數據庫喺論文版本合併、收錄範圍同引用識別方面存在較大差異。因此,本文唔係專注去比較多個數據庫嘅差別,亦唔會將不同數據庫嘅數據混合成一個嚴格嘅全球排名,而係以Google Scholar上嘅最新數據為主,選取十篇引文數據最多、有代表性嘅高引用論文,觀察佢哋嘅學術影響力同佢哋喺AI技術發展中嘅地位。
一、十篇代表性AI論文嘅引用數據變化
下表將2025年原文記錄嘅引用量同而家可以查到嘅最新Google Scholar統計數據進行對照。由於兩次統計嘅數據庫同收錄口徑未必完全一致,表中數字主要用於觀察量級同變化趨勢,唔能將差值直接理解為同一數據庫喺呢段時間內新增嘅引用次數。
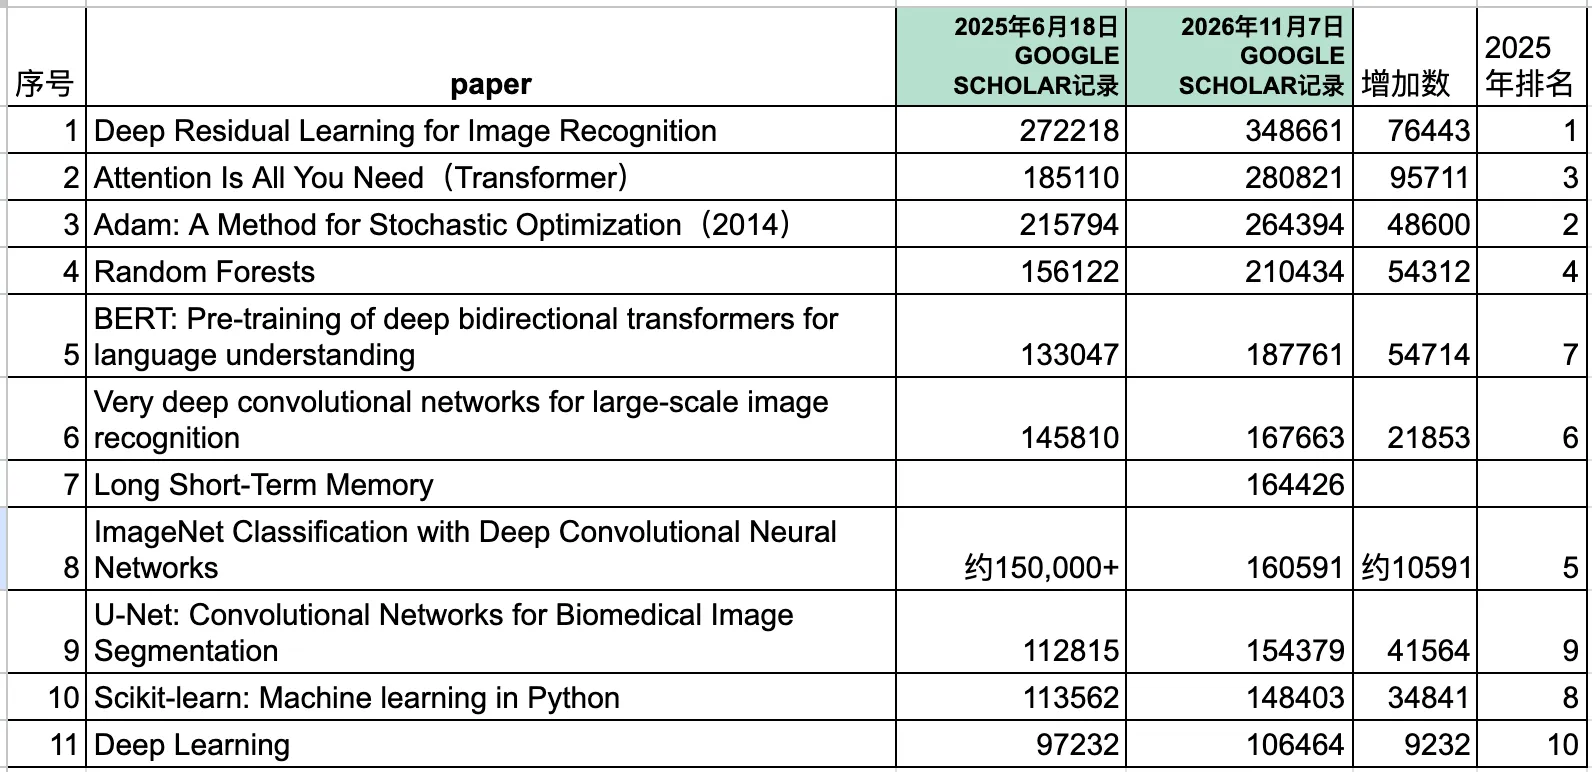
從呢組數據可以見到幾個值得關注嘅現象。
首先,Transformer同Adam依然係深度學習領域最具影響力嘅基礎研究之一。佢哋分別解決咗序列建模同神經網絡優化中嘅關鍵問題,至今仍然係大量現代AI系統嘅技術基礎。
其次,ResNet嘅影響力依然突出。佢所提出嘅殘差連接已經成為深層神經網絡設計中嘅重要思想,唔局限於圖像識別領域。
第三,經典視覺模型並冇因為生成式AI嘅興起而失去學術價值。AlexNet、VGG同U‑Net所代表嘅研究,仍然構成計算機視覺技術發展史嘅重要組成部分。
第四,Long Short‑Term Memory喺去年度嘅榜單中遺漏,今次我哋將佢加入,因為佢係Transformer出現之前最受歡迎嘅序列模型之一。
二、十篇具代表性嘅AI里程碑論文
1. Deep Residual Learning for Image Recognition(ResNet,2015/2016)
作者:Kaiming He、Xiangyu Zhang、Shaoqing Ren、Jian Sun
論文鏈接:arXiv:1512.03385
ResNet係現代深度學習發展史上最重要嘅架構創新之一。何恺明等人喺2015年提出呢個方法,並於2016年發表相關會議論文,解決咗深層神經網絡喺層數增加時出現嘅優化退化問題。
傳統神經網絡通常直接學習輸入到輸出嘅映射關係,而ResNet引入咗殘差學習機制,令網絡學習輸入同目標輸出之間嘅差值。其核心表達式為:
[H(x)=F(x)+x]
其中,x係輸入,F(x)係網絡要學習嘅殘差映射。通過恆等映射嘅跳躍連接,輸入可以直接傳遞到後續層,從而改善深層網絡嘅優化過程。
論文提出咗ResNet‑34、ResNet‑50、ResNet‑101同ResNet‑152等唔同深度嘅網絡結構。其中,ResNet‑152喺ImageNet圖像分類任務中取得咗當時領先嘅結果,推動深度神經網絡進入更深層次嘅架構設計階段。
技術影響:
- 殘差連接成為深層神經網絡嘅重要基礎設計。
- 促進咗DenseNet、Inception‑ResNet等後續架構嘅發展。
- 殘差思想被廣泛應用喺Transformer、視覺模型同多模態網絡。
ResNet嘅重要性唔單止係提升咗圖像識別嘅準確率,更係改變咗研究人員構建深層神經網絡嘅方式。
2. Attention Is All You Need(Transformer,2017)
作者:Ashish Vaswani等八位研究人員
論文鏈接:arXiv:1706.03762
如果話ResNet改變咗深度視覺網絡嘅設計方式,咁Transformer就徹底改變咗自然語言處理嘅發展方向。
2017年,Google研究團隊發表《Attention Is All You Need》,提出完全基於注意力機制嘅序列建模架構,擺脫咗傳統循環神經網絡(RNN)對序列逐步處理嘅依賴。
Transformer嘅核心係自注意力機制(Self‑Attention)。模型通過Query、Key同Value三個向量計算序列中唔同Token之間嘅關聯程度,令每個Token能夠根據上下文動態聚合其他Token嘅信息。
其核心計算形式為:
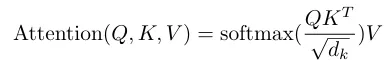
呢個設計帶來咗幾個重要突破:
- 並行計算: 相比傳統RNN,Transformer能夠更充分利用GPU進行並行訓練。
- 長距離依賴建模: 自注意力機制可以直接建立序列不同位置之間嘅聯繫。
- 架構擴展性: 模型可以通過增加層數、隱藏維度同訓練數據規模持續擴展。
原始Transformer喺WMT 2014英德同英法機器翻譯任務中分別取得28.4同41.8嘅BLEU成績,展示咗注意力架構喺序列建模中嘅優勢。
此後,BERT、GPT、T5以及大量多模態模型都採用咗Transformer或其衍生結構。今日嘅大語言模型技術體系,好大程度上建立喺呢篇論文提出嘅架構思想之上。
技術影響: Transformer唔單止係一種新嘅神經網絡架構,更係現代基礎模型發展嘅關鍵起點。佢令研究人員可以通過擴大模型規模、訓練數據同計算資源,持續探索更強大嘅模型能力。
3. Adam: A Method for Stochastic Optimization(2014)
作者:Diederik P. Kingma、Jimmy Ba
論文鏈接:arXiv:1412.6980
Adam(Adaptive Moment Estimation)係深度學習中最具影響力嘅優化算法之一。佢結合咗Momentum嘅一階動量估計同RMSProp嘅二階動量估計,為唔同模型參數提供自適應學習率。
Adam通過指數加權平均分別估計梯度嘅一階矩同二階矩,並通過偏差校正改善訓練早期嘅估計效果。
其主要優勢包括:
- 為唔同參數自動調整學習率。
- 對稀疏梯度同非平穩目標函數具有較好適應能力。
- 喺好多深度學習任務中能夠提供穩定、高效嘅優化表現。
Adam及其變體AdamW、AMSGrad、RAdam等,已經廣泛應用喺Transformer、BERT、GPT及各類生成模型嘅訓練。
值得注意嘅係,Adam唔係喺所有任務中都優於SGD。例如喺部分計算機視覺任務中,經過精心調參嘅SGD仍然有競爭力。但Adam嘅通用性同易用性,使佢成為現代深度學習訓練流程中嘅重要基礎工具。
技術影響: Adam嘅意義在於降低咗深層神經網絡優化嘅工程門檻,使研究人員能夠更高效咁訓練複雜模型。隨著模型規模不斷增長,優化算法嘅穩定性同效率仍然係決定模型訓練成本嘅重要因素。
4. Random Forests(2001)
作者:Leo Breiman
論文鏈接:Machine Learning期刊
Random Forests(隨機森林)係傳統機器學習領域最具代表性嘅集成學習算法之一。
Leo Breiman喺2001年發表嘅論文系統提出咗隨機森林方法,通過組合多棵決策樹嚟提高預測性能同模型泛化能力。
其核心機制包括:
- Bootstrap採樣: 由原始訓練數據有放回抽取多個子集。
- 隨機特徵選擇: 每棵樹喺節點分裂時只考慮隨機選取嘅部分特徵。
- 集成決策: 分類任務通過多數投票,回歸任務通過平均預測結果形成最終輸出。
隨機森林具有較強嘅魯棒性,能處理非線性關係,並且可以提供特徵重要性分析,因此喺金融風控、醫學診斷、生物信息同工業預測等領域仍有廣泛應用。
相比近年快速發展嘅深度學習,隨機森林唔需要大量GPU資源,亦唔一定需要海量訓練數據。喺結構化數據任務中,佢仍係值得優先考慮嘅基線模型。
技術影響: 呢篇論文證明咗通過多個相對簡單模型合理集成,可以獲得比單一模型更穩定嘅預測能力。集成學習思想至今仍然影響住機器學習系統嘅設計。
5. BERT: Pre‑training of Deep Bidirectional Transformers for Language Understanding(2018)
作者:Jacob Devlin、Ming‑Wei Chang、Kenton Lee、Kristina Toutanova
論文鏈接:arXiv:1810.04805
BERT係自然語言處理發展史上一個重要里程碑。
2018年,Google AI團隊提出BERT(Bidirectional Encoder Representations from Transformers),通過雙向Transformer編碼器學習文本嘅上下文表示,改變咗傳統自然語言處理任務中為唔同任務分別訓練模型嘅方式。
BERT採用大規模無標注文本進行預訓練,然後針對具體任務進行微調,主要使用兩種訓練目標:
- Masked Language Modeling(MLM): 隨機遮蓋輸入文本中嘅部分Token,令模型根據上下文去預測被遮蓋嘅內容。
- Next Sentence Prediction(NSP): 喺原始BERT中,通過判斷兩個句子是否有連續關係,幫助模型學習句子之間嘅關係。
BERT喺GLUE、SQuAD同SWAG等多項自然語言理解基準測試中取得咗當時領先成績。
佢嘅主要貢獻係證明咗大規模預訓練模型可以學到通用嘅語言表示,並可以通過微調遷移到唔同下游任務。
技術影響:
- 推動咗預訓練語言模型成為自然語言處理嘅主流方法。
- 催生咗RoBERTa、ALBERT同DistilBERT等模型。
- 為搜索、文本分類、問答同語義理解系統提供咗重要技術基礎。
需要區分嘅係,BERT屬於以編碼器為核心嘅雙向語言表示模型,而GPT系列主要採用自回歸生成方式。兩者都建立喺Transformer基礎之上,但訓練目標同應用方向有所不同。
6. Very Deep Convolutional Networks for Large‑Scale Image Recognition(VGG,2014)
作者:Karen Simonyan、Andrew Zisserman
論文鏈接:arXiv:1409.1556
VGG網絡由牛津大學視覺幾何組提出,系統研究咗增加卷積網絡深度對圖像識別性能嘅影響。
其最具代表性嘅結構係VGG‑16同VGG‑19。VGG嘅核心設計理念係使用多個連續嘅3×3小卷積核代替較大嘅卷積核,通過增加網絡深度提升特徵表達能力。
例如,幾層3×3卷積層可以喺獲得較大感受野嘅同時,引入更多非線性變換。
VGG嘅主要特點包括:
- 結構簡單,網絡模塊高度規則。
- 通過小卷積核堆疊增加網絡深度。
- 能夠提取具有較強表達能力嘅視覺特徵。
VGG喺ImageNet 2014競賽中取得咗優異成績。儘管佢嘅參數量同計算成本較高,但結構清晰、易於理解同復現,因此長期被用於視覺研究同遷移學習。
技術影響: VGG證明咗網絡深度同結構設計對視覺特徵學習嘅重要性,亦為後續深度卷積網絡嘅發展提供咗重要參考。
7. Long Short‑Term Memory(LSTM,1997)
作者: Sepp Hochreiter、Jürgen Schmidhuber
論文鏈接: DOI: 10.1162/neco.1997.9.8.1735
如果話傳統循環神經網絡(RNN)開啟咗序列數據建模,咁LSTM就解決咗RNN難以學習長期依賴關係嘅重要問題,為後來嘅自然語言處理同序列學習奠定咗基礎。
1997年,Hochreiter同Schmidhuber發表《Long Short‑Term Memory》,提出長短期記憶網絡。其核心創新係喺循環神經網絡中引入記憶單元(Cell State)同門控機制,令模型能夠有選擇咁保留、更新同輸出歷史信息,從而緩解傳統RNN訓練過程中容易出現嘅梯度消失問題。
LSTM主要包含三個門控結構:
- 遺忘門(Forget Gate): 決定邊啲歷史信息需要保留,邊啲可以丟棄。
- 輸入門(Input Gate): 控制當前輸入中邊啲信息寫入記憶單元。
- 輸出門(Output Gate): 決定記憶單元中邊啲信息用於當前輸出。
呢個設計帶來咗幾個重要突破:
- 長期依賴學習: 改善傳統RNN難以捕捉長距離信息關聯嘅問題。
- 動態記憶管理: 模型能夠根據輸入內容決定信息嘅保留、更新同輸出。
- 廣泛嘅應用能力: 適用於自然語言處理、語音識別、機器翻譯同時間序列預測等任務。
此後,LSTM及其變體GRU成為Transformer出現前序列建模領域嘅主流架構。2017年Transformer提出後,注意力機制逐漸成為大規模語言模型嘅核心技術,但LSTM至今仍喺部分實時語音處理、時間序列預測同資源受限場景中發揮作用。
技術影響: LSTM嘅重要貢獻唔單止係改進咗RNN嘅訓練方式,仲係證明咗神經網絡可以通過專門設計嘅信息控制機制,有效管理長期上下文。呢個思想亦為後來研究點樣喺神經網絡中組織、篩選同利用信息提供咗重要啟發。
8. ImageNet Classification with Deep Convolutional Neural Networks(AlexNet,2012)
作者:Alex Krizhevsky、Ilya Sutskever、Geoffrey Hinton
論文鏈接:ACM Digital Library
AlexNet係深度學習發展史上一個關鍵轉折點。
2012年,Alex Krizhevsky、Ilya Sutskever同Geoffrey Hinton利用深度卷積神經網絡,喺ImageNet大規模圖像分類競賽中取得突破性成績。該模型包含約6000萬個參數,使用5個卷積層同3個全連接層,喺當年嘅ImageNet分類任務中取得約15.3%嘅Top‑5錯誤率,顯著優於當時傳統方法。
AlexNet嘅主要技術創新包括:
- ReLU激活函數: 改善深層網絡嘅訓練效率。
- GPU並行訓練: 利用兩塊GPU完成大規模圖像模型訓練。
- Dropout: 降低全連接層嘅過擬合風險。
- 數據增強: 通過圖像變換提升模型泛化能力。
AlexNet最重要嘅意義係證明咗喺大規模數據集同GPU計算支持下,深度卷積神經網絡可以明顯超越當時嘅傳統圖像識別方法。
呢個成果直接推動咗深度學習喺計算機視覺領域嘅普及,亦加速咗GPU喺人工智能研究中嘅應用。
技術影響: AlexNet標誌住深度學習喺現代計算機視覺領域取得決定性突破,並成為後來ResNet、VGG同其他視覺網絡發展嘅重要基礎。
9. Scikit‑learn: Machine Learning in Python(2011)
作者:F. Pedregosa等
論文鏈接:Journal of Machine Learning Research
Scikit‑learn唔係一種新嘅機器學習算法,而係一個極具影響力嘅Python機器學習工具庫。
2011年,Fabian Pedregosa等人發表論文,系統介紹咗Scikit‑learn嘅設計理念、算法實現同軟件架構。
Scikit‑learn提供咗統一嘅API,覆蓋分類、回歸、聚類、降維、特徵處理、模型選擇同評估等多個機器學習環節。
其最重要嘅工程設計之一,係統一咗模型訓練與預測接口:
fit():訓練模型。predict():生成預測結果。transform():進行特徵轉換。
呢種標準化接口極大地降低咗機器學習應用開發嘅複雜度,令研究人員可以更加方便咁切換算法、組合處理流程同開展實驗。
技術影響: Scikit‑learn推動咗Python成為機器學習同數據科學領域重要嘅開發語言,亦建立咗大量開發者熟悉嘅機器學習工程實踐規範。
10. U‑Net: Convolutional Networks for Biomedical Image Segmentation(2015)
作者:Olaf Ronneberger、Philipp Fischer、Thomas Brox
論文鏈接:arXiv:1505.04597
U‑Net最初係為生物醫學圖像分割任務設計嘅深度學習架構,後來成為圖像分割領域最具影響力嘅網絡結構之一。
其核心設計係對稱嘅編碼器—解碼器結構:
- 編碼器逐步降低圖像空間分辨率,提取更高層次嘅語義特徵。
- 解碼器逐步恢復空間分辨率,生成精細嘅像素級預測。
- 跳躍連接將編碼器中嘅高分辨率特徵傳遞畀解碼器,彌補下採樣過程中流失嘅空間信息。
U‑Net尤其適合醫學圖像分割,因為醫學影像往往需要喺有限訓練樣本下準確識別器官、組織同病變區域。
此後,U‑Net及其衍生架構被廣泛應用喺醫學影像、遙感、農業、工業檢測同自動駕駛等領域。
技術影響: U‑Net建立咗經典嘅編碼器—解碼器分割架構範式,其跳躍連接設計亦影響咗大量後續視覺模型。
11. Deep Learning(2015)
作者:Yann LeCun、Yoshua Bengio、Geoffrey Hinton
論文鏈接:Nature
2015年,Yann LeCun、Yoshua Bengio同Geoffrey Hinton喺Nature發表綜述論文《Deep Learning》,系統總結咗深度學習嘅基本原理、發展歷史同主要應用。
文章回顧咗深層神經網絡喺計算機視覺、語音識別同自然語言處理等領域嘅進展,並分析咗大規模數據、GPU計算同優化算法對深度學習發展嘅推動作用。
論文強調咗深度學習嘅核心思想:通過多層神經網絡逐步學習數據嘅層次化表示,從原始輸入中自動提取具有唔同抽象程度嘅特徵。
佢唔單止總結咗CNN、RNN同深度生成模型等技術,亦解釋咗點解深層網絡能喺複雜任務中取得優異表現。
技術影響:
- 系統總結咗深度學習嘅理論基礎同技術發展。
- 推動咗深度學習成為人工智能研究嘅核心方向。
- 為後續大規模神經網絡、Transformer同基礎模型嘅發展提供咗重要背景。
儘管佢喺排行榜上可能退出咗前十,但作為深度學習嘅總結與奠基之作,呢篇論文嘅價值唔止係總結已有成果,仲係幫助學術界同產業界理解深度學習技術革命背後嘅共通規律。
三、由十篇經典論文睇AI技術發展嘅三個階段
回顧呢十篇論文,可以發現現代AI嘅發展並唔係由某一個算法單獨推動,而係多個基礎技術方向相互促進嘅結果。
第一階段:深度學習基礎能力嘅建立
AlexNet、VGG同ResNet代表咗深度卷積神經網絡嘅發展過程。
AlexNet證明咗GPU、大規模數據同深度神經網絡結合嘅巨大潛力;VGG進一步探索咗網絡深度同特徵表達之間嘅關係;ResNet則解決咗深層網絡訓練中嘅重要優化問題。
呢一階段嘅核心任務,係令神經網絡能夠由大量數據中自動學習複雜特徵。
第二階段:通用模型同工程化體系嘅形成
Adam、Random Forests同Scikit‑learn分別代表咗模型優化、集成學習同機器學習工程化三個方向。
呢啲研究共同推動咗機器學習由單一算法實驗走向可復用、可擴展嘅工程體系。
與此同時,BERT同U‑Net進一步展示咗預訓練模型同特定任務架構嘅價值,使AI能喺語言理解同精細視覺任務中取得更強表現。
第三階段:Transformer同基礎模型時代
2017年Transformer嘅提出,係現代AI發展史上一個關鍵轉折點。
相比傳統針對單一任務設計嘅模型,Transformer具備更強嘅並行計算能力同架構擴展能力。通過擴大模型參數、訓練數據同計算資源,研究人員逐步構建出具備通用表示同生成能力嘅基礎模型。
此後,大語言模型、多模態模型同AI Agent快速發展,人工智能開始由單一任務模型向能處理多種任務嘅通用系統演進。
四、經典論文嘅引用量意味住乜嘢?
論文引用量係衡量學術影響力嘅重要指標,但佢唔等於技術價值,也唔可以簡單理解為某項技術嘅實際應用規模。
一篇論文被大量引用,可能代表佢提出咗新嘅基礎方法,亦可能係因為佢成為某個研究方向嘅標準參考文獻,或者提供咗廣泛使用嘅工具同數據集。
例如,Transformer嘅影響力唔單來自論文本身嘅引用數量,更多來自佢對整個大模型技術路線嘅深刻影響;Scikit‑learn嘅價值則更多體現在機器學習工程生態同開發者實踐中。
因此,評價一篇AI論文嘅歷史地位,至少需考慮三個維度:
- 學術影響力: 論文被後續研究引用嘅廣度同深度。
- 技術影響力: 論文提出嘅方法是否改變咗後續算法同模型架構嘅設計。
- 產業影響力: 相關技術是否真正進入主流軟件、硬件同商業產品。
從呢個角度睇,引用量只係觀察AI技術演進嘅一扇窗,而唔係衡量技術貢獻嘅唯一標準。
結語:AI下一次技術突破會嚟自邊度?
呢十篇論文跨越咗二十多年,覆蓋咗深度學習、優化算法、計算機視覺、自然語言處理同機器學習工程等多個方向。佢哋共同構成咗今日人工智能技術體系嘅重要基礎。
但AI嘅發展冇停留喺Transformer時代。
而家嘅研究正向更複雜方向演進,包括推理能力、強化學習、多模態融合、世界模型、具身智能、AI Agent同持續學習等。未來嘅突破可能唔會再單靠擴大模型參數規模,而係來自更有效嘅數據組織、更高效嘅訓練方法、更合理嘅模型架構,甚至係模型同真實物理世界之間更緊密嘅互動。
由AlexNet到ResNet,由BERT到Transformer,再到今日嘅大語言模型,每一次重要突破都係建立喺之前研究成果嘅基礎上。
真係改變AI發展方向嘅,往往唔係某一個模型有幾大,而係研究人員提出咗一種可以畀整個技術體系持續採用嘅新方法。 呢亦正係呢啲經典論文多年之後仍然值得重讀嘅原因。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com