
自從2006年AI領域引入深度學習以來,人工智能(AI)(特別係以大型語言模型 LLM 為基礎嘅 AI)正以史無前例嘅速度席捲全球,其深遠影響已由實驗室走向產業實踐,重塑我哋嘅工作模式、生活方式甚至社會結構。由生成式AI到自動駕駛,從醫療診斷到金融風控,AI 嘅應用幾乎無所不在。喺呢場變革背後,一批奠定技術基礎嘅里程碑論文發揮咗決定性作用。佢哋唔單止推動咗算法突破,亦深刻影響咗整個學術界同工業界嘅技術演進。
本文盤點咗截至目前被引用次數最多嘅十篇AI頂級論文(數據來源:Google Scholar)。呢啲論文嘅引用量全部超過咗十萬次,堪稱「AI 知識金字塔嘅基石」。佢哋所提出嘅算法同框架,例如 ResNet、Adam、Transformer、BERT 等,已經深度融入今日主流 AI 系統,成為無數工程同產品背後嘅「隱形支柱」。
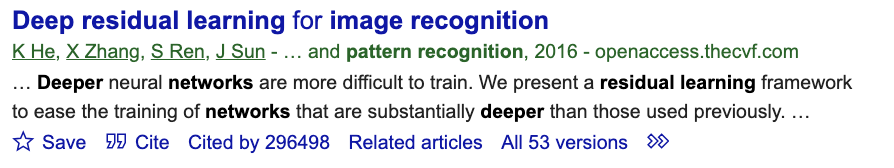
1. “Deep Residual Learning for Image Recognition” (He et al., 2016)
🔗 Google Scholar: Kaiming He et al.
喺深度神經網絡訓練中,隨住層數加深,通常會出現梯度消失或退化問題(訓練誤差唔降反升)。為解決呢個瓶頸,何恺明等人喺2015年提出咗殘差網絡(ResNet)。其核心係將「學習殘差」(residual)作為目標,即模型學習輸入 x 與輸出 F(x) 之間嘅增量,而唔係直接擬合 H(x)。具體透過「恆等映射跳躍連接」(identity skip‑connections)把輸入直接加到輸出上,令網絡優化更穩定。
佢哋構建咗 ResNet‑50、101、152 等多個版本,最深達到152層,仍能高效訓練。喺 ImageNet 圖像分類任務上,ResNet‑152 以僅 3.57% 嘅錯誤率獲勝,並喺 ImageNet、COCO 等多項競賽上贏得多項任務冠軍,打破咗「網絡越深越容易退化」嘅迷思,成為計算機視覺同視覺 AI 嘅里程碑。
截至目前,佢仍係AI領域被引用次數最高嘅論文之一。
✨ 影響
- ResNet 架構被廣泛應用於圖像分類、目標檢測、分割
- 引導後續深度模型設計,如 DenseNet、Inception‑ResNet
- 跳躍連接思想被引入 Transformer、AlphaFold 等多個領域
2025‑12‑11 截圖
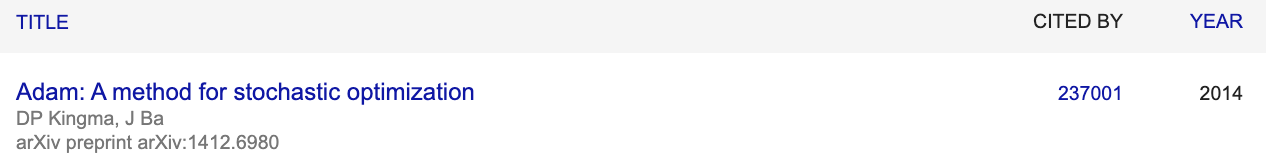
2. Adam: A method for stochastic optimization(DP Kingma, J Ba 2014)
🔗 Google Scholar: Kingma & Ba, 2015
2015年,Diederik P. Kingma 同 Jimmy Ba 喺 ICLR 發表嘅論文《Adam: A Method for Stochastic Optimization》提出咗一種高效嘅隨機優化算法——Adam(Adaptive Moment Estimation),成為深度學習領域最常用嘅參數優化器之一。呢個方法結合咗Momentum(一階矩估計)同RMSProp(二階矩估計)嘅思想,能以自適應學習率對每個參數進行動態調整。
Adam 透過對梯度嘅一階同二階動量分別做指數加權平均,並引入偏差校正,喺訓練早期提供穩定估計。其更新公式唔單止魯棒,對超參數亦唔太敏感,預設設定已可適用於大部分深度學習任務。
相比 SGD,Adam 具有快速收斂、處理稀疏梯度嘅能力,因此被廣泛應用於神經網絡訓練,尤其喺自然語言處理、圖像生成、強化學習等領域。佢亦成為 TensorFlow、PyTorch 等主流框架中嘅常用優化器。
✨ 影響
- 取代 SGD 成為深度學習中最常用嘅優化器
- 啟發咗眾多變體(如 AdamW、AMSGrad、RAdam 等)
- 廣泛應用於 Transformer、GAN、BERT、GPT 等主流模型訓練中
📈 目前引用次數超過 237,000 次,係機器學習史上引用量排名前十嘅論文之一。
2025‑12‑11 截圖
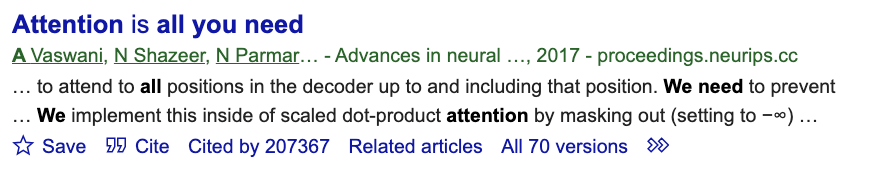
3. “Attention Is All You Need” (2017, Vaswani et al.)
🔗 Google Scholar: Vaswani et al. scholar.google.com
2017年,當時仍喺 Google 工作嘅 Vaswani 等八位作者發表嘅呢篇論文提出咗Transformer架構,徹底顛覆咗自然語言處理(NLP)領域。核心思想係放棄傳統嘅循環(RNN)或卷積結構,完全依賴「自注意力機制」(self‑attention)嚟計算序列中每個輸入標記對其他標記嘅重要性,呢種設計帶來兩大突破:
- 更強嘅並行性:傳統嘅 RNN 同 CNN 依賴順序處理,性能瓶頸明顯,而 Transformer 嘅結構令訓練高度並行化,速度大幅提升。
- 更長嘅上下文捕捉:自注意力允許模型直接存取輸入序列中任意位置,加強咗對長距離依賴嘅理解。
論文基於 WMT 2014 英→德同英→法翻譯任務取得嘅成績(分別係 BLEU 值 28.4 同 41.8),相比當時 baselines 有明顯領先。而且僅需 8 塊 GPU,訓練時間短、效果高。此後 Transformer 被廣泛用於 LLM、機器翻譯、摘要、問答,直到今日所有 GPT 系列同大量多模態模型(如 GPT‑4 等)都源自呢個機制,係21世紀引用次數最高嘅論文之一,至今逾 207, 000+ 次引用。
✨ 影響
- 成為 BERT、GPT、T5 等模型嘅理論基礎
- 推動 NLP 進入大模型時代
- 引導研究者探索用注意力機制處理圖像、音頻等多模態任務
2025‑12‑11 截圖
4. Random forests(L Breiman 2001)
🔗 Google Scholar 引用頁面:Leo Breiman
2001年,統計學家 Leo Breiman 喺《Machine Learning》期刊上發表咗劃時代嘅論文《Random Forests》,系統性地提出咗隨機森林算法。呢個方法結合咗「決策樹集成」同「隨機特徵選擇」嘅思想,大幅提升咗分類與回歸任務中模型嘅性能同泛化能力,係機器學習中最具影響力嘅集成學習算法之一。
其核心機制包括:
- Bagging(自助抽樣):對訓練數據多次有放回抽樣,訓練出多棵獨立決策樹;
- 特徵子集隨機選擇:每棵樹喺每個節點分裂時,僅喺隨機選取嘅特徵子集中尋找最佳劃分,增強模型多樣性;
- 多數投票 / 均值融合:分類任務中採用投票機制,回歸任務中使用平均值合併結果。
隨機森林具備高準確率、抗過擬合、可評估特徵重要性等優勢,適用於高維數據同不平衡數據場景,並廣泛用於金融風控、醫學診斷、生物信息等多個行業。該論文奠定咗現代集成學習嘅基礎,截至2025年底,引用次數已超過170,000次,堪稱經典。
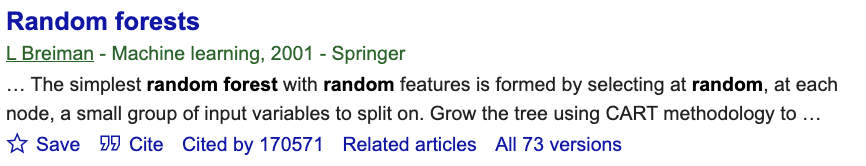
2025‑12‑11 截圖
5. Very deep convolutional networks for large‑scale image recognition(K Simonyan, A Zisserman 2014)
🔗 Google Scholar: Simonyan & Zisserman, 2014
2014年,牛津大學視覺幾何組(VGG)嘅 Karen Simonyan 同 Andrew Zisserman 發表咗著名論文《Very Deep Convolutional Networks for Large‑Scale Image Recognition》,系統性探索咗網絡深度對圖像識別性能嘅影響。論文提出咗一系列由11層到19層嘅卷積神經網絡結構,其中最具代表性嘅模型係 VGG‑16 同 VGG‑19。
VGG 嘅核心設計理念係:透過堆疊多個 3×3 細卷積核代替大卷積,提升模型非線性表達能力,並增加網絡深度以增強性能。喺 ImageNet ILSVRC 2014 分類任務中,VGG 模型取得咗 Top‑5 錯誤率 7.3% 嘅優異成績,僅次於 GoogLeNet。
儘管其參數量同計算開銷較大,但由於結構規則、模組化強,VGGNet 成為後續模型嘅常用骨幹(例如 Faster R‑CNN、Style Transfer 等)。佢亦為 ResNet 等更深網絡奠定咗實踐基礎,係深度視覺模型設計史上嘅里程碑。
✨ 影響
- 提出「細卷積 + 深層堆疊」設計範式,影響深遠
- 成為計算機視覺任務中最常用嘅特徵提取器之一
- 為 ResNet 等後續架構提供基礎結構同思路
📈 目前引用次數超過 154,000 次,係計算機視覺領域引用量最高嘅論文之一。
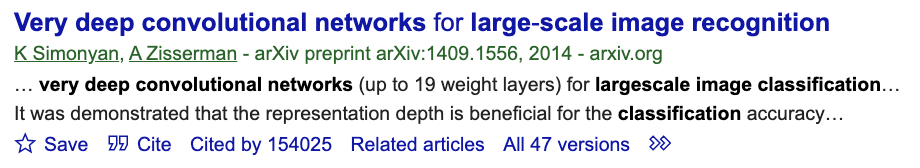
2025‑12‑11 截圖
6. BERT: Pre‑training of deep bidirectional transformers for language understanding(J Devlin, MW Chang, K Lee 2019)
🔗 Google Scholar: Devlin et al., 2018
2018年,Google AI 嘅 Jacob Devlin 等人發佈咗開創性論文《BERT》,首次提出用深度雙向 Transformer 結構做語言模型預訓練。BERT(Bidirectional Encoder Representations from Transformers)徹底改變咗自然語言理解(NLU)嘅範式,引入咗「預訓練 + 微調」嘅方法論。
BERT 嘅創新在於使用 雙向自注意力機制,透過 Masked Language Model(MLM)同 Next Sentence Prediction(NSP)進行預訓練,令模型喺理解上下文時唔再局限於單向結構(例如 GPT 係由左至右)。呢點令 BERT 能捕捉更豐富嘅句法同語義信息。
BERT 喺包括 GLUE、SQuAD、SWAG 等多項 NLP 基準任務上刷新咗當時最佳成績,佢發佈嘅 bert-base 同 bert-large 模型成為業界標準。佢亦為後續如 RoBERTa、ALBERT、DistilBERT 等系列奠定咗基礎。
✨ 影響
- 開創「預訓練 + 微調」新範式,幾乎重塑 NLP 全生態
- 推動大規模語料訓練成為主流
- 成為問答、情感分析、文本分類等任務嘅基石模型
📈 當前引用次數已超過 151,000+,係自然語言處理史上最具影響力嘅論文之一。
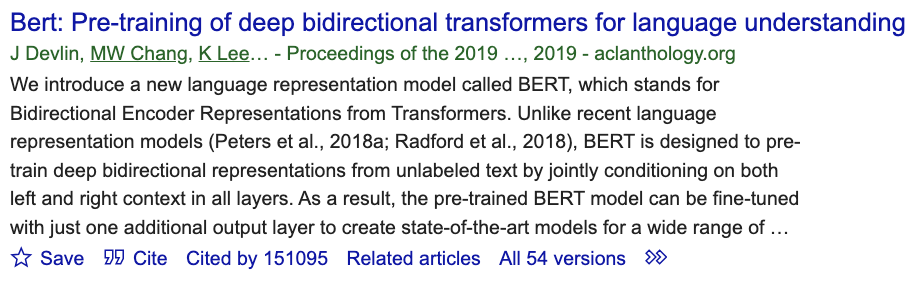
2025‑12‑11 截圖
7. ImageNet Classification with Deep Convolutional Neural Networks (AlexNet, Krizhevsky et al., 2012)
🔗 Google Scholar 引用頁面:Alex Krizhevsky / Geoffrey Hinton
2012年,Alex Krizhevsky、Ilya Sutskever 同 Geoffrey Hinton 聯合發表咗呢篇革命性嘅論文,首次將大型卷積神經網絡(CNN)引入 ImageNet 圖像分類任務,創造性咁改寫咗計算機視覺嘅歷史。該網絡包含 60 百萬參數、5 層卷積 + 3 層全連接層,喺1000類 ImageNet 圖像識別任務中實現咗 Top‑5 錯誤率 15.3%,比此前第二名高出超過10個百分點,徹底打破咗當時嘅性能記錄。
其核心創新包括:
- ReLU 激活函數:首次系統性使用 ReLU(取代 tanh/sigmoid),令訓練速度大幅提升,並緩解梯度消失問題;
- GPU 加速訓練:利用雙 GPU 並行訓練,令網絡訓練時間由數周縮短到幾日;
- Dropout 正則化:喺全連接層中引入 dropout,有效減輕過擬合;
- 局部響應正規化(LRN):保持神經元響應適度競爭,增強泛化能力。
呢篇論文唔單止展示咗 CNN 喺大規模圖像任務上嘅可行性,仲融合咗多項深度學習關鍵技術,奠定咗現代視覺模型嘅基礎。自此,深度學習潮流席捲整個 AI 領域,推動 GPU 加速生態系統同開源框架(例如 Caffe、TensorFlow)嘅快速發展。根據 Google Scholar,截至2025年年底,該論文被引用超過 150,000 次,成為 AI 研究中最具里程碑意義嘅經典文獻之一。
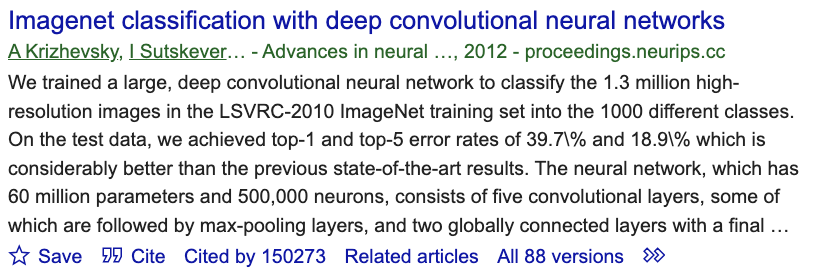
2025‑12‑11 截圖
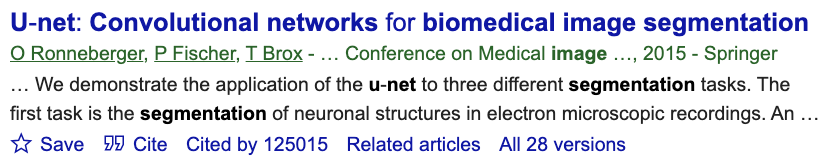
8. U‑Net: Convolutional Networks for Biomedical Image Segmentation(O Ronneberger, P Fischer, T Brox 2015)
🔗 Google Scholar: Ronneberger et al., 2015
2015年,德國弗賴堡大學嘅 Olaf Ronneberger 等人喺 MICCAI 發表咗論文《U‑Net: Convolutional Networks for Biomedical Image Segmentation》,提出咗專為醫學圖像分割設計嘅深度卷積網絡架構 U‑Net。該網絡採用對稱嘅「編碼器–解碼器」結構,並透過跳躍連接(skip connections)將高分辨率特徵由編碼器傳遞到解碼器,提升咗分割精度。
U‑Net 命名源自其特有嘅 U 形結構:左側負責提取語義特徵(壓縮路徑),右側恢復空間信息(上採樣路徑)。呢種設計喺只需少量訓練樣本嘅醫學影像領域尤其高效,同時兼顧定位精度同上下文理解能力。
該方法喺多個醫學圖像分割挑戰賽(例如 ISBI 2015)中取得領先成績,並迅速擴展到遙感、農業、工業質檢等領域。由於其結構清晰、效果強大,U‑Net 被視為語義分割領域最具影響力嘅架構之一。
✨ 影響
- 開創編碼器–解碼器結構 + 跳躍連接嘅分割範式
- 廣泛應用於醫學圖像、衛星圖像、自動駕駛等視覺分割任務
- 催生眾多變體(如 U‑Net++, Attention U‑Net, nnU‑Net 等)
📈 當前引用次數已超過 125,000 次,係圖像分割與醫學影像領域引用量最高嘅論文之一。
2025‑12‑11 截圖
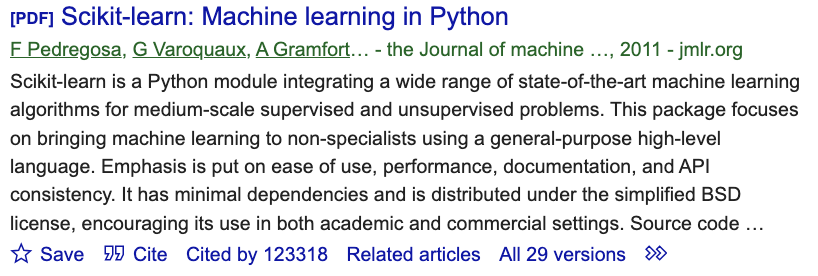
9. Scikit‑learn: Machine learning in Python(F Pedregosa, G Varoquaux, A Gramfort 2011)
🔗 Google Scholar: Pedregosa et al., 2011
2011年,Fabian Pedregosa 等人發表咗論文《Scikit‑learn: Machine Learning in Python》,介紹咗 Python 生態中最廣泛使用嘅機器學習工具庫之一 —— Scikit‑learn。該庫建立喺 NumPy、SciPy 同 matplotlib 等基礎庫之上,提供咗豐富、統一且高效嘅 API 介面,涵蓋分類、回歸、聚類、降維、模型選擇、預處理等多個子模組。
Scikit‑learn 嘅核心理念係:簡單易用 + 模組化設計 + 面向對象 API,令非專業開發者都可以快速部署機器學習模型。其統一嘅 .fit() / .predict() / .transform() 接口規範,大大降低咗模型切換同流水線構建嘅複雜度。
該庫成為 Python 數據科學生態嘅基石,被廣泛應用於教學、科研與工業界原型開發,並影響咗包括 TensorFlow、PyTorch Lightning、XGBoost、LightGBM 等其他工具嘅 API 設計。
✨ 影響
- 建立機器學習工程標準 API 規範
- 推動 Python 成為主流數據科學語言
- 成為教學與科研入門機器學習嘅首選工具包
📈 當前引用次數已超過 123,000 次,係機器學習工程實踐領域引用量最高嘅論文之一。
2025‑12‑11 截圖
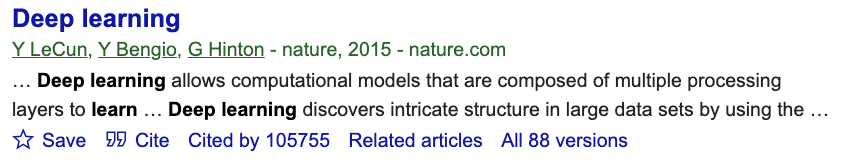
10. Deep learning(Y LeCun, Y Bengio, G Hinton 2015)
🔗 Google Scholar: LeCun, Bengio & Hinton, 2015
2015年,Yann LeCun、Yoshua Bengio 同 Geoffrey Hinton 三位圖靈獎得主喺《Nature》發表咗綜述論文《Deep Learning》,全面總結咗深度學習喺計算機視覺、語音識別、自然語言處理等多個領域嘅突破性進展。呢篇文章唔單止系統梳理咗深度神經網絡(尤其係卷積神經網絡 CNN 同循環神經網絡 RNN)嘅技術演進,亦明確咗深度學習嘅基本原則:多層次嘅特徵表示 + 端到端訓練 + 大數據支持。
文章回顧咗由感知機到反向傳播(Backpropagation)、由自編碼器到深度信念網絡(DBN)、由 AlexNet 到實際工業應用嘅演變,並強調咗GPU 計算、大規模數據集、改進嘅優化算法(例如 ReLU、Dropout、Adam 等)喺深度學習崛起中嘅關鍵作用。
該論文喺學術界同工業界都產生咗深遠影響,被視為深度學習作為獨立研究方向嘅里程碑性綜述。
✨ 影響
- 奠定深度學習三巨頭地位,推動 AI 進入主流技術革命
- 成為人工智能教育、研究與產業實踐嘅權威綜述
- 引導後續 Transformer、強化學習、大模型等方向發展
📈 當前引用次數已超過 105,000 次,係《Nature》上引用最多嘅計算機科學論文之一。
2025‑12‑11 截圖
總觀呢十篇高引用論文,佢哋共同構建起當代人工智能嘅核心技術版圖。由圖像識別中嘅 ResNet、VGG、AlexNet,到自然語言理解領域嘅 Transformer 與 BERT,再到優化算法如 Adam 同工具生態如 Scikit‑learn,無一唔喺推動 AI 從理論到工程落地嘅道路上扮演關鍵角色。
更重要嘅係,呢啲論文唔單止係科學成果嘅總結,仲係未來技術創新嘅起點。佢哋激發出大量衍生研究,帶動新一輪嘅大模型架構、多模態融合、可解釋性 AI、自動化機器學習(AutoML)等發展方向。隨住 AI 喺社會中嘅滲透程度不斷加深,我哋有理由相信,未來會有更多劃時代嘅論文湧現,繼續書寫「人類 + 機器智能」嘅新篇章。
▶️ 創作唔易,歡迎關注我哋嘅 YouTube 頻道:https://www.youtube.com/@airosetta 並點讚、收藏!🙏