
近年来,人工智能(AI)(特别是以大语言模型LLM为基础的AI)正以前所未有的速度席卷全球,其深远影响已从实验室走向产业实践,重塑了我们的工作方式、生活模式乃至社会结构。从生成式AI到自动驾驶,从医疗诊断到金融风控,AI 的应用几乎无处不在。在这场变革浪潮背后,一批奠定技术基础的里程碑论文发挥了决定性作用。它们不仅推动了算法的突破,更深刻地影响了整个学术界和工业界的技术演进。
本文盘点了截至目前被引用次数最多的十篇AI顶级论文。这些论文的引用量大多超过了十万次,堪称“AI 知识金字塔的基石”。它们所提出的算法和框架,如 ResNet、Adam、Transformer、BERT 等,已经深度融入当今主流 AI 系统中,成为无数工程和产品背后的“隐形支柱”。
1. “Deep Residual Learning for Image Recognition” (He et al., 2016)
🔗 Google Scholar: Kaiming He et al.
在深度神经网络训练中,随着层数加深,往往会出现梯度消失或退化问题(训练误差不降反升)。为解决这一瓶颈,何恺明等人在 2015 年提出了 残差网络(ResNet)。其核心是将“学习残差”(residual)作为目标,即模型学习输入 xxx 与输出 F(x)F(x)F(x) 的增量,而不是直接拟合 H(x)H(x)H(x)。具体通过“恒等映射跳跃连接”(identity skip‑connections)把输入直接加到输出上,使网络优化更稳定。
他们构建了 ResNet‑50、101、152 等多个版本,最深的达到 152 层,却依然能高效训练。在 ImageNet 图像分类任务上,ResNet‑152 以仅 3.57% 的错误率获胜,并在 ImageNet、COCO等多项竞赛上获得多项任务冠军,该论文突破了“网络越深越容易”“深度必须受限”的迷思,成为 CV 和视觉 AI 的里程碑。
截止目前,它仍是AI领域的论文引用冠军。
✨ 影响
- ResNet 架构被广泛应用于图像分类、目标检测、分割
- 引导后续深度模型设计,如 DenseNet、Inception‑ResNet
- 跳跃连接思想被引入 Transformer、AlphaFold 等多种领域
2025‑06‑18截图
2. Adam: A method for stochastic optimization(DP Kingma, J Ba 2014)
🔗 Google Scholar: Kingma & Ba, 2015
2015 年,Diederik P. Kingma 与 Jimmy Ba 在 ICLR 上发表的论文《Adam: A Method for Stochastic Optimization》提出了一种高效的随机优化算法——Adam(Adaptive Moment Estimation),成为深度学习领域最常用的参数优化器之一。该方法结合了 Momentum(一阶矩估计)和 RMSProp(二阶矩估计)思想,能以自适应的学习率对每个参数进行动态调整。
Adam 通过对梯度的一阶和二阶动量分别进行指数加权平均,并引入偏差校正,在训练早期提供稳定估计。其更新公式不仅鲁棒,而且对超参数不敏感,默认设置即可适用于大多数深度学习任务。
与 SGD 相比,Adam 具有快速收敛、处理稀疏梯度的能力,因此被广泛应用于神经网络训练,尤其是在自然语言处理、图像生成、强化学习等领域。它也成为 TensorFlow、PyTorch 等主流框架中的默认优化器之一。
✨ 影响
- 取代 SGD 成为深度学习中最常用优化器
- 启发了众多变体(如 AdamW、AMSGrad、RAdam 等)
- 广泛应用于 Transformer、GAN、BERT、GPT 等主流模型训练中
📈 目前引用次数超过 215,000 次,是机器学习历史上引用量排名前十的论文之一。
3. “Attention Is All You Need” (2017, Vaswani et al.)
🔗 Google Scholar: Vaswani et al. scholar.google.com
2017 年,还在Google工作的Vaswani 等八人共同发表的这篇论文提出了 Transformer 架构,它彻底颠覆了自然语言处理(NLP)领域。核心思想是抛弃传统的循环(RNN)或卷积结构,完全依赖“自注意力机制”(self‑attention)来计算序列中每个输入标记对其他标记的重要性,这种设计带来了两个突破:
- 更强的并行性:传统的 RNN 和 CNN 依赖顺序处理,性能瓶颈显著,而 Transformer 的结构使训练高度并行化,速度大幅提升。
- 更长的上下文捕捉:自注意力允许模型直接访问输入序列中的任意位置,加强了对长距离依赖的理解。
论文是在 WMT 2014 英 → 德和英 → 法翻译任务上分别取得BLEU值 28.4 和 41.8 的成绩的基础上输出的,其成绩大幅领先当时的 baselines。而且仅需 8 块 GPU,训练时间短、效果高。此后 Transformer 被广泛用于LLM、机器翻译、摘要、问答,到今天所有 GPT 系列、大量多模态模型(如 GPT‑4 等)都源于此机制,是 21 世纪引用次数最高的论文之一,至今逾 185 000+ 次引用。
✨ 影响
- 成为 BERT、GPT、T5 等模型的理论基础
- 推动 NLP 进入大模型时代
- 引导研究者探索用注意力机制处理图像、音频等多模态任务
2025‑06‑18截图
4. Random forests(L Breiman 2001)
🔗 Google Scholar 引用页面:Leo Breiman
2001 年,统计学家 Leo Breiman 在《Machine Learning》期刊上发表了划时代论文《Random Forests》,系统提出了随机森林算法。这一方法结合了“决策树集成”与“随机特征选择”的思想,极大地提升了分类与回归任务中的模型性能与泛化能力,是机器学习中最具影响力的集成学习算法之一。
其核心机制包括:
- Bagging(自助采样):对训练数据多次有放回抽样,训练出多棵独立的决策树;
- 特征子集随机选择:每棵树在每个节点分裂时,仅从随机选取的特征子集中寻找最佳划分,增强模型多样性;
- 多数投票 / 均值融合:分类任务中采用投票机制,回归任务中使用平均值合并结果。
随机森林具备高准确率、抗过拟合、可评估特征重要性等优势,适用于高维数据和不平衡数据场景,并广泛用于金融风控、医学诊断、生物信息等多个行业。该论文奠定了现代集成学习的基础,截至 2025 年,引用次数已超过 156,000 次,堪称经典。
2025‑06‑19截图
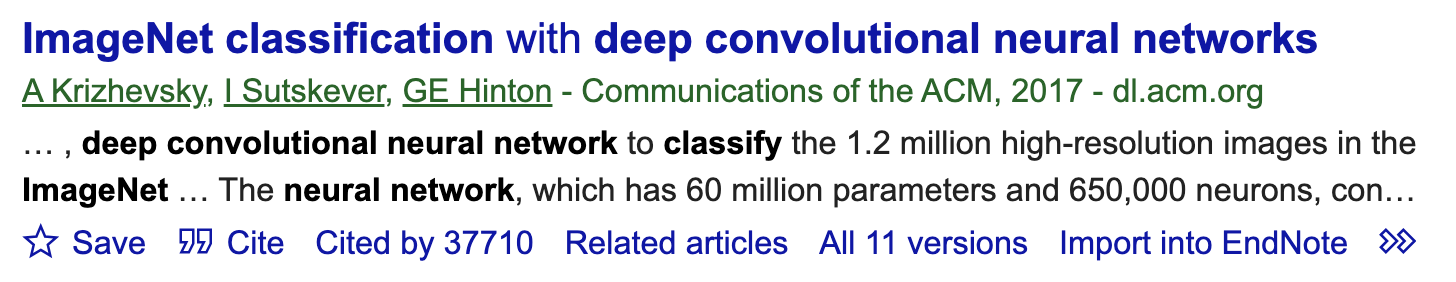
5. “ImageNet Classification with Deep Convolutional Neural Networks” (AlexNet, Krizhevsky et al., 2012)
🔗 Google Scholar 引用页面:Alex Krizhevsky / Geoffrey Hinton
2012 年,Alex Krizhevsky、Ilya Sutskever 和 Geoffrey Hinton 联合发布了这篇革命性的论文,首次引入了大规模 卷积神经网络(CNN) 到 ImageNet 图像分类任务中,创造性地改写了计算机视觉的史册。该网络包含 60 百万参数、5 层卷积 + 3 层全连接层,在 1000 类 ImageNet 图像识别任务中实现了 Top‑5 错误率 15.3%,比此前第二名高出超过 10 个百分点,彻底打破了当时的性能记录。
其核心创新包括:
- ReLU 激活函数:首次系统地使用 ReLU(取代 tanh/sigmoid),使训练速度大幅提升,并缓解梯度消失问题;
- GPU 加速训练:利用双 GPU 并行训练,使网络的训练时间从数周缩短至几天;
- Dropout 正则化:在全连接层中引入 dropout,有效减轻过拟合;
- 局部响应归一化(LRN):保持神经元响应适度竞争,增强泛化能力。
这篇论文不仅展示了 CNN 在大规模图像任务上的可行性,还融合了多项深度学习关键技术,奠定了现代视觉模型的基础。从此,深度学习潮流席卷整个 AI 领域,推动 GPU 加速生态系统和开源框架(如 Caffe、TensorFlow)的迅速发展。根据 Google Scholar,截至 2025 年,该论文被引用 超过 37,700+ 次,成为 AI 研究中最具有里程碑意义的经典文献之一
2025‑06‑18截图
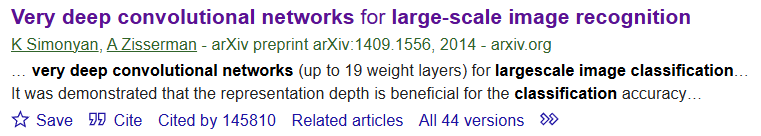
6. Very deep convolutional networks for large‑scale image recognition(K Simonyan, A Zisserman 2014)
🔗 Google Scholar: Simonyan & Zisserman, 2014
2014 年,牛津大学视觉几何组(VGG)的 Karen Simonyan 与 Andrew Zisserman 发表了著名论文《Very Deep Convolutional Networks for Large‑Scale Image Recognition》,系统探索了网络深度对图像识别性能的影响。论文提出了一系列深度从 11 到 19 层的卷积神经网络结构,其中最具代表性的模型是 VGG‑16 和 VGG‑19。
VGG 的核心设计理念是:通过堆叠多个 3×3 小卷积核代替大卷积,提升模型非线性表达能力,并增加网络深度以增强性能。在 ImageNet ILSVRC 2014 分类任务中,VGG 模型取得了 Top‑5 错误率 7.3% 的优异成绩,仅次于 GoogLeNet。
尽管其参数量和计算开销较大,但由于结构规则、模块化强,VGGNet 成为后续模型的常用骨干(如 Faster R‑CNN、Style Transfer 等)。它也为 ResNet 等更深网络奠定了实践基础,是深度视觉模型设计史上的里程碑。
✨ 影响
- 提出“小卷积 + 深层堆叠”设计范式,影响深远
- 成为计算机视觉任务中最常用的特征提取器之一
- 为 ResNet 等后续架构提供基础结构与思路
📈 目前引用次数超过 145,000 次,是计算机视觉领域引用量最高的论文之一。
2025‑06‑19截图
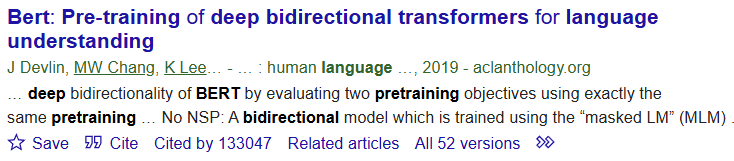
7. BERT: Pre‑training of deep bidirectional transformers for language understanding(J Devlin, MW Chang, K Lee 2019)
🔗 Google Scholar: Devlin et al., 2018
2018 年,Google AI 的 Jacob Devlin 等人发布了开创性论文《BERT》,首次提出利用深度双向 Transformer 结构进行语言建模预训练。BERT(Bidirectional Encoder Representations from Transformers)彻底改变了自然语言理解(NLU)的范式,引入了 “预训练 + 微调” 的方法论。
BERT 的创新在于使用 双向自注意力机制,通过 Masked Language Model(MLM)和 Next Sentence Prediction(NSP)进行预训练,使模型在理解上下文时不再局限于单向结构(如 GPT 是从左到右)。这使得 BERT 能捕捉更丰富的句法与语义信息。
BERT 在包括 GLUE、SQuAD、SWAG 等多项 NLP 基准任务上刷新了当时的最佳成绩,其发布的 bert-base 和 bert-large 模型成为业界标准。它也为后续如 RoBERTa、ALBERT、DistilBERT 等系列奠定了基础。
✨ 影响
- 开创“预训练 + 微调”新范式,几乎重塑 NLP 全生态
- 推动大规模语料训练成为主流
- 成为问答、情感分析、文本分类等任务的基石模型
📈 当前引用次数已超过 133,000+,是自然语言处理史上最具影响力的论文之一。
2025‑06‑19截图
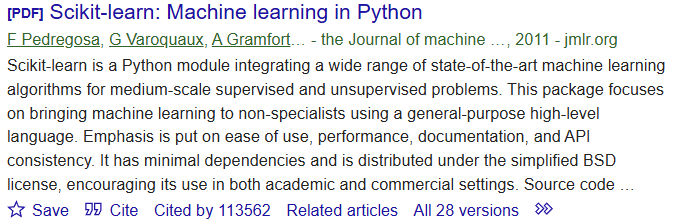
8. Scikit‑learn: Machine learning in Python(F Pedregosa, G Varoquaux, A Gramfort 2011)
🔗 Google Scholar: Pedregosa et al., 2011
2011 年,Fabian Pedregosa 等人发表了论文《Scikit‑learn: Machine Learning in Python》,介绍了 Python 生态中最广泛使用的机器学习工具库之一 —— Scikit‑learn。该库建立在 NumPy、SciPy 和 matplotlib 等基础库之上,提供了丰富、统一且高效的 API 接口,涵盖分类、回归、聚类、降维、模型选择、预处理等多个子模块。
Scikit‑learn 的核心理念是:简单易用 + 模块化设计 + 面向对象 API,使得非专业开发者也可以快速部署机器学习模型。其统一的 .fit() / .predict() / .transform() 接口规范,极大降低了模型切换与流水线构建的复杂度。
该库成为 Python 数据科学生态的基石,被广泛应用于教学、科研与工业界原型开发,并影响了包括 TensorFlow、PyTorch Lightning、XGBoost、LightGBM 等其他工具的 API 设计。
✨ 影响
- 建立机器学习工程标准 API 规范
- 推动 Python 成为主流数据科学语言
- 成为教学与科研入门机器学习的首选工具包
📈 当前引用次数已超过 113,000 次,是机器学习工程实践领域引用量最高的论文之一。
2025‑06‑19截图
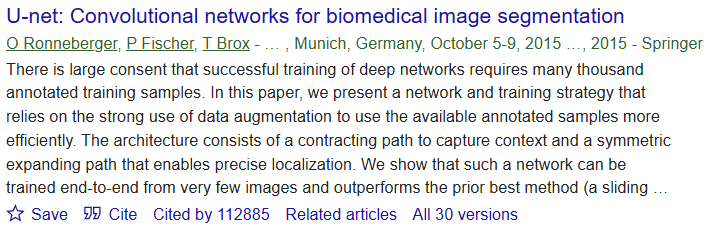
9. U‑Net: Convolutional Networks for Biomedical Image Segmentation(O Ronneberger, P Fischer, T Brox 2015)
🔗 Google Scholar: Ronneberger et al., 2015
2015 年,德国弗赖堡大学的 Olaf Ronneberger 等人在 MICCAI 上发表了论文《U‑Net: Convolutional Networks for Biomedical Image Segmentation》,提出了专为医学图像分割设计的深度卷积网络架构 U‑Net。该网络采用对称的“编码器–解码器”结构,并通过跳跃连接(skip connections)将高分辨率特征从编码器传递至解码器,提升了分割精度。
U‑Net 的命名源自其特有的 U 形结构:左侧负责提取语义特征(压缩路径),右侧恢复空间信息(上采样路径)。这种设计在只需少量训练样本的医学影像领域尤为高效,同时兼顾了定位精度与上下文理解能力。
该方法在多个医学图像分割挑战赛(如 ISBI 2015)中取得了领先成绩,并迅速扩展至遥感、农业、工业质检等领域。由于其结构清晰、效果强大,U‑Net 被认为是语义分割领域最具影响力的架构之一。
✨ 影响
- 开创编码器–解码器结构 + 跳跃连接的分割范式
- 广泛应用于医学图像、卫星图像、自动驾驶等视觉分割任务
- 催生众多变体(如 U‑Net++, Attention U‑Net, nnU‑Net 等)
📈 当前引用次数已超过 112,000 次,是图像分割与医学影像领域引用量最高的论文之一。
2025‑06‑19截图
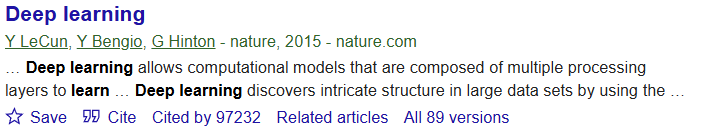
10. Deep learning(Y LeCun, Y Bengio, G Hinton 2015)
🔗 Google Scholar: LeCun, Bengio & Hinton, 2015
2015 年,Yann LeCun、Yoshua Bengio 和 Geoffrey Hinton 三位图灵奖得主在《Nature》发表综述论文《Deep Learning》,全面总结了深度学习在计算机视觉、语音识别、自然语言处理等多个领域的突破性进展。这篇文章不仅系统梳理了深度神经网络(尤其是卷积神经网络 CNN 和循环神经网络 RNN)的技术演进,也明确了深度学习的基本原则:多层次的特征表示 + 端到端训练 + 大数据支持。
文中回顾了从感知机到反向传播(Backpropagation)、从自动编码器到深度信念网络(DBN)、从 AlexNet 到实际工业应用的演变,强调了 GPU 计算、大规模数据集、改进的优化算法(如 ReLU、Dropout、Adam 等)在深度学习崛起中的关键作用。
该论文在学术界和工业界都产生了深远影响,被认为是深度学习作为独立研究方向的里程碑标志之一。
✨ 影响
- 奠定深度学习三巨头地位,推动 AI 进入主流技术革命
- 成为人工智能教育、研究与产业实践的权威综述
- 引导后续 Transformer、强化学习、大模型等方向发展
📈 当前引用次数已超过 97,000 次,是《Nature》上引用最多的计算机科学论文之一。
2025‑06‑19截图
综观这十篇高引用论文,它们共同构建起当代人工智能的核心技术版图。从图像识别中的 ResNet、VGG、AlexNet,到自然语言理解领域的 Transformer 与 BERT,再到优化算法如 Adam 与工具生态如 Scikit‑learn,无一不在推动 AI 理论向工程落地演进的道路上扮演关键角色。
更重要的是,这些论文不仅是科学成果的总结,更是未来技术创新的起点。它们激发出众多衍生研究,带动新一轮的大模型架构、多模态融合、可解释性AI、自动机器学习(AutoML)等发展方向。随着 AI 在社会中的渗透程度不断加深,我们有理由相信,未来还将有更多划时代的论文涌现,持续书写“人类 + 机器智能”的崭新篇章。